在大模型单卡显存与算子优化逐步逼近物理极限的当下,大模型基础设施的竞争焦点正在整体位移。2026 年 10 月 20 日的 PyTorch Conference 上,开源分布式推理调度栈 llm-d 正式推出 v1.0.0 版本,并宣布归入 CNCF(云原生计算基金会)托管。这一动作表面上是 Google Cloud 与开源社区为集群推理补齐网络拼图,实则是云厂商与软硬件联盟试图在分布式调度层打破 NVIDIA 闭环生态的重要一役。
当多轮对话和长上下文智能体调用成为主流,重复发送的大段系统提示词(System Prompt)和对话历史导致大量重复计算。推理过程由计算密集的预填充(prefill)与显存带宽密集的解码(decode)构成,如果每次请求都被轮询算法分发到没有历史状态的节点,集群将承受庞大的冗余算力消耗。llm-d 1.0 的核心逻辑,正是将 Kubernetes 的调度能力延伸至大模型内部状态,通过前缀缓存感知路由,让请求精确命中已经持有相应 KV 缓存的算力副本。
85% 延迟降幅背后的基线技巧与代码悬案
Google Cloud 官方在发布会上给出了极具吸引力的测试数字:在 Ironwood / TPU 7x 集群的智能体编程场景中,前缀感知路由方案将中位数首字延迟(TTFT)降低超过 85%,并将集群总吞吐拉升至原来的 2.4 倍。在商业客户落地上,ZenteiQ 在 1,000 张 TPU v6e 上的合成数据生成场景中,日生成 Token 容量从 14.7 亿攀升至 59.7 亿,整体吞吐提升超过 4 倍。
集群吞吐提升的真实底牌,从来不是单张算力卡的微调,而是网络对显存状态的穿透。
然而,剖析这组亮眼数字背后的对照基准,会发现宣传口径里的复合效应。官方公布的 85% 降幅并非纯粹由路由器调度算法贡献,而是将前缀感知路由与主机内存分层卸载方案叠加后,去对比完全没有针对大模型做优化的原生 Kubernetes Service。如果剥离掉内存卸载带来的状态驻留收益,纯粹的路由调度很难达到如此巨大的跨度。耐人寻味的是,Google 官方在推广博文中给出的底层 GitHub 复现代码链接,在发布当天便直接陷入 404 无法访问的尴尬境地。
历史记录也表明,这并非 1.0 版本的全新突变。早在 2026 年 2 月,Vertex AI 平台上就已经借助 Lustre 存储加速和类似缓存路由技术实现了 35% 的 TTFT 削减与缓存命中率翻倍。llm-d 1.0 真正完成的,是将这套曾经深埋在云厂商专有平台内的机制剥离出来,封装进云原生标准框架,并拓展到底层执行引擎与异构硬件生态中。
在针对 16 张 H100 GPU(部署 8 个 vLLM 实例)的严格对照测试中,调度粒度的差异暴露无遗。如果采用传统随机路由,由于缓存频繁未命中引发重算,P90 TTFT 高达 92.551 秒;退一步采用估算状态的近似缓存感知路由,时延降至 31.083 秒;而一旦启用与推理引擎实时同步的精准缓存感知路由,P90 首字延迟骤降至 0.542 秒。此时系统的总输出吞吐量达到 8,730.0 tokens/s,相比随机路由的 4,428.7 tokens/s 实现了接近翻倍的提升。
TPU 适配暗坑与云原生的代理人战争
从纸面测试跨入生产落地,开发者立刻会撞上一批严苛的工程边界。尽管 llm-d 1.0 强调了对 Google Cloud TPU 的原生支持,但底层适配仍存在不少工程陷阱。
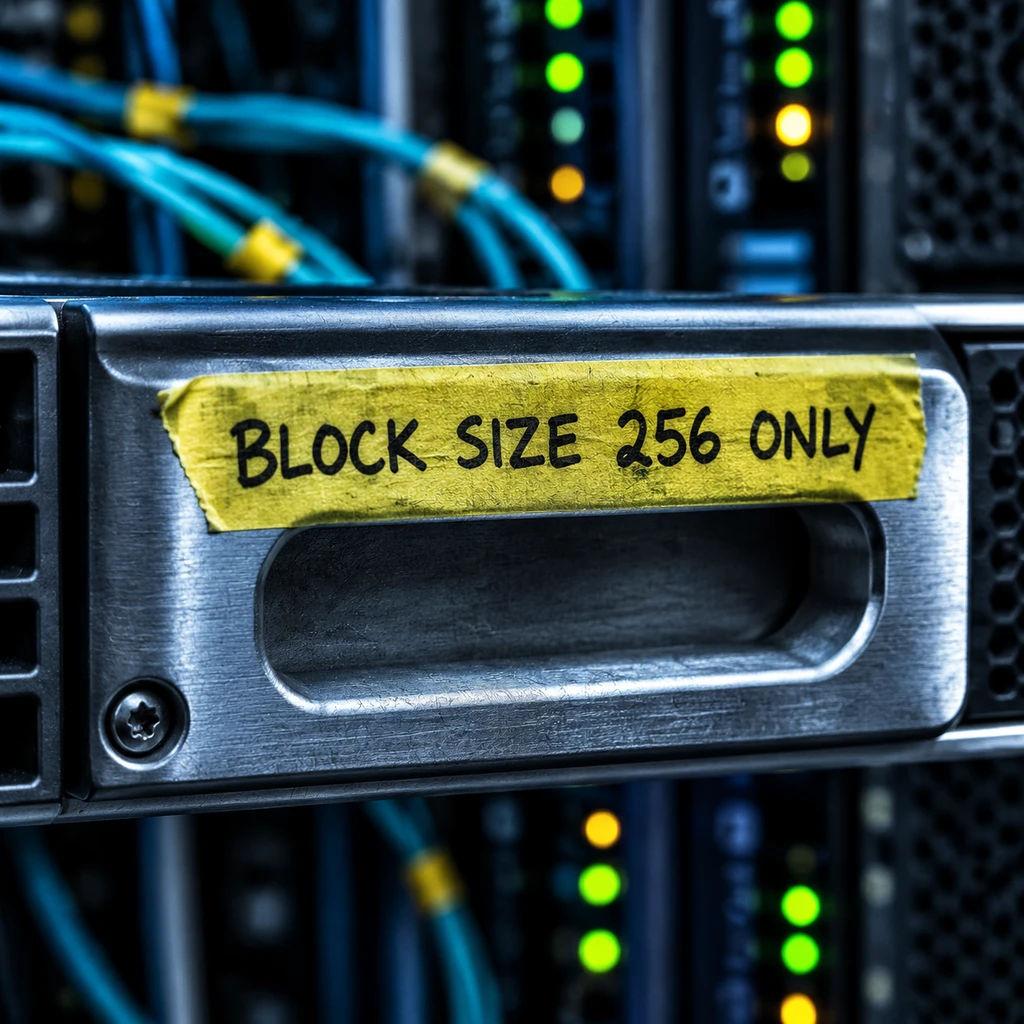
- 风险.TPU v6e 的 Torch TPU 后端在参数设为
--block-size=64时会直接遭遇共享内存(SMEM)耗尽崩溃;运维团队必须通过部署 overlay 强制将其固定为 256,且调度器端必须同步写入blockSizeTokens: 256才能维持正常握手。
此外,硬件成熟度在社区中呈现显著分水岭。在官方代码仓库的自动化测试矩阵里,只有上一代的 TPU v5p 享有持续的每日构建(nightly CI)保障;业界当前主力采购的 TPU v6e 以及最新的 v7 硬件,依然被归入社区维护(community-maintained)阵营。翻看社区提交的记录,关于多级存储分层感知不完整以及分布式遥测盲区的讨论屡见不鲜。
这场技术升级更深层的张力,在于算力阵营之间的生态博弈。llm-d 最初于 2025 年 5 月由 Red Hat、Google Cloud、IBM Research、CoreWeave 及 NVIDIA 共同发起。但在这个看似和谐的联盟背后,各方的算盘截然不同。
NVIDIA 参与 llm-d 并贡献了底层传输协议 NIXL,但其商业重心始终放在自家高度垂直绑定的私有编排系统 NVIDIA Dynamo 上。对 Google Cloud 和 Red Hat 而言,绝不能任由推理集群的控制权被锁定在绿色芯片巨头的专有软件栈中。llm-d 从初期单纯绑定 vLLM,演进到 1.0 版本吸纳 SGLang 与 TorchTPU,正是为了用 CNCF 的云原生标准,搭建一座能横跨 TPU 与各类 GPU 的通用调度层。
- 建议.对于正在承受高频 Agent 账单压力的平台团队,llm-d 1.0 提供的缓存感知调度架构确实能立竿见影地榨取集群吞吐;但在直接切换生产环境前,仍须等待 Google 补齐验证代码,并针对底层内存参数做好定制兜底。