2026 年 10 月 5 日 19 时 11 分 UTC,GitHub 状态监控页再次切入故障排查模式。官方报告显示,GitHub Actions 遭遇性能降级,核心症结出在官方托管 Runner(GitHub-hosted runners)的分配环节产生大面积延迟,导致跨多种系统配置的工作流启动时间被严重拉长。截至 19 时 50 分 UTC,技术团队仍在排查排队堆积并推行缓解措施。
表面上看,这只是一次常见的云端排队卡顿,但对全球依赖自动化代码合并与部署的软件团队来说,整条交付链条瞬间停摆。当持续集成与部署(CI/CD)全面收拢于中心化托管平台,开发者省去了维护物理机与虚拟机的繁琐工作,却也把整套工程运转的底线交付给了远端的黑盒调度。
调度停滞与分配积压:官方托管计算池再次卡壳
根据官方事故报告(Incident 3q1yb5m7ltvb),本次故障并非代码仓库读写中断,而是专注于作业分发与执行环节。开发者提交 Pull Request 后,触发的构建流水线迟迟无法获取计算资源,大量任务卡在等待分配虚拟机的队列中。
官方在通报中尚未给出具体根因。就在四天前的 2026 年 10 月 1 日,Actions 刚刚发生过一起因上游 Azure 依赖触发限流并返回 HTTP 429 错误引发的事故,但官方目前并未将 10 月 5 日的问题与其归为同类。官方文档特别提示,定时触发任务在整点高负载时出现排队属于既定设计,但这与全局突发的调度挂起有着本质区别。
这种由中心化调配引发的堵塞,并非单一部署区域的个例,而是跨越了多种操作系统镜像的算力分配。对于高度依赖分支保护规则的研发团队,自动化检查无法通过,意味着合规发布被迫就地暂停。
冰山之下:两年五次停摆暴露出脆弱单点
将时间线拉长,Runner 排队和启动延迟在 GitHub 的工程历史上频繁重演,暴露出集中式调度架构在极端工况下的弹性瓶颈。
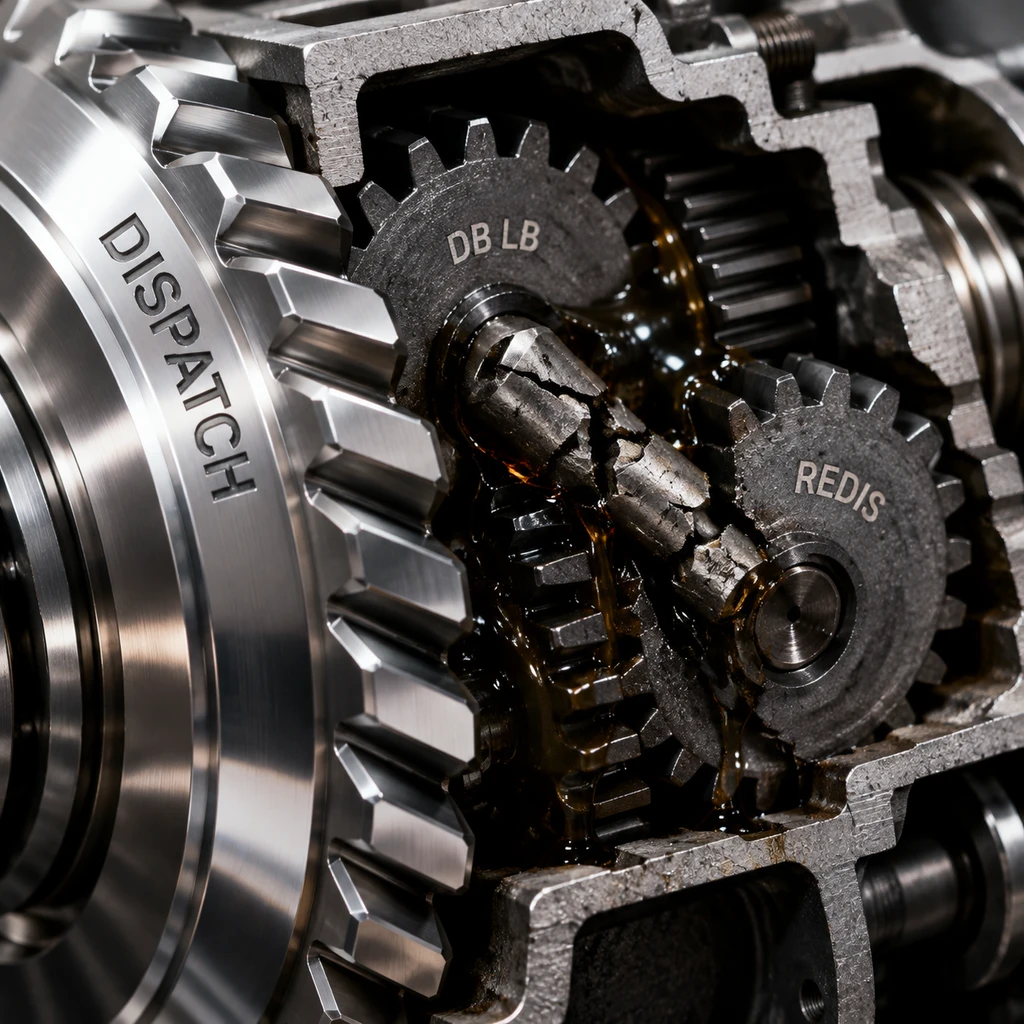
2024 年 4 月 5 日,一次数据库负载均衡器变更导致关键连接失效,在短短 47 分钟 内造成超过 100,000 个工作流未能正常启动。同年 7 月 18 日至 19 日,上游网络故障叠加跨地域多活无法正常故障转移,多达 50% 的任务 直接卡死在等待队列中。
进入 2025 年,类似的架构耦合依然存在。2025 年 3 月 12 日,Redis 集群连接故障与热同步延迟,导致约 0.8% 的工作流平均推迟 1 小时启动,0.6% 最终启动失败;同年 5 月 28 日,故障转移后的缓存配置错误又引发重复派单,导致公开仓库中 19.7% 的 Ubuntu 24 托管作业 遭遇交付延迟。
这些记录说明了一个事实:无论上层界面如何平滑,托管型 Actions 始终高度依赖底层虚拟机秒级调配、分布式缓存一致性以及主干数据库的吞吐极限。任何微小的网络抖动或上游云服务配额收紧,都会顺着调度链路放大为全球性的工程堵塞。
托管服务的便利性有多高,其掩盖的基础设施脆弱点就有多深。
全托管便利背后的代价:自建冗余正成企业刚需
面对中心化调度的不确定性,开发组织内部正在出现清晰的分化。继续完全依赖 GitHub-hosted runners 意味着把发布的稳定性交由第三方掌控;而在金融、自动驾驶和核心电商等发布容忍度极低的领域,团队开始重新核算这笔可靠性税。
竞品工具的存在给出了不同维度的解法。GitLab CI/CD 凭借全栈开源架构提供更直观的私有部署支撑,CircleCI 在特定并发场景和构建缓存控制上表现稳健,而采用 Buildkite 这类混合模式则将控制面与计算面彻底分离。
更多深耕 GitHub 生态的团队,则选择将算力收拢到基于 Kubernetes 的自建扩缩容体系(Actions Runner Controller, ARC)。通过在私有云或自选虚拟私有云(VPC)中部署节点池,企业仅使用 GitHub 的任务分发信令,实际容器冷启动与运行完全脱离中心化算力排队。
- 风险.自建自托管 Runner 虽能规避公有资源池的排队风暴,但会把底层安全沙箱隔离、补丁维护与闲置算力成本完整转嫁给内部平台运维团队。
依赖中心化全托管并非无解,关键在于区分核心与非核心链路。若一次线上 Hotfix 会因几十分钟的 Runner 排队而动弹不得,工程团队就必须在完全托管与混合自建之间,设立一道确定性的容灾分界线。