2026年10月30日,GitHub 状态页贴出一份编号为 pwxsjgnvrk6b 的故障通告,记录 GitHub Actions、Pages 和 Webhooks 出现了 42分钟 的性能降级与延迟。如果只看这一页,你会以为这只是周五下午一场 1 小时 33 分钟就彻底收尾的偶发小颠簸。但把当天的故障日志和开发者社区报错拼在一起,就会发现 GitHub Pages 当天其实是一天两崩,无数研发团队面对的根本不是慢一点,而是 0 个 job 的僵尸工作流卡死在队列里,既取消不掉,重试还直接弹 403 错误。
先把这起事故的账面数据和隐情交代清楚:
- 发生时间与跨度.10月30日 17:50 UTC 开始调查,18:32 UTC 缓解恢复(核心受损 42分钟),19:23 UTC 结束监控,总跟踪窗口 1 小时 33 分钟。
- 波及范围.Webhooks 事件、GitHub Actions 工作流、GitHub Pages 部署,以及代码搜索(code search)和实时更新(live updates)。
- 被折叠的前序故障.同日 14:31 至 15:02 UTC(本次故障前约 3 小时),Issues 和 Pages 刚经历过另一场独立故障,官方归因为 14:21 至 14:30 UTC 某组件暂时过载。
- 更早的异常信号.社区开发者反馈,定时工作流(scheduled workflows)自 10月29日 起就已无法正常触发,仅手动和 push 触发有效。
状态页写的是延迟,开发者撞上的是死锁
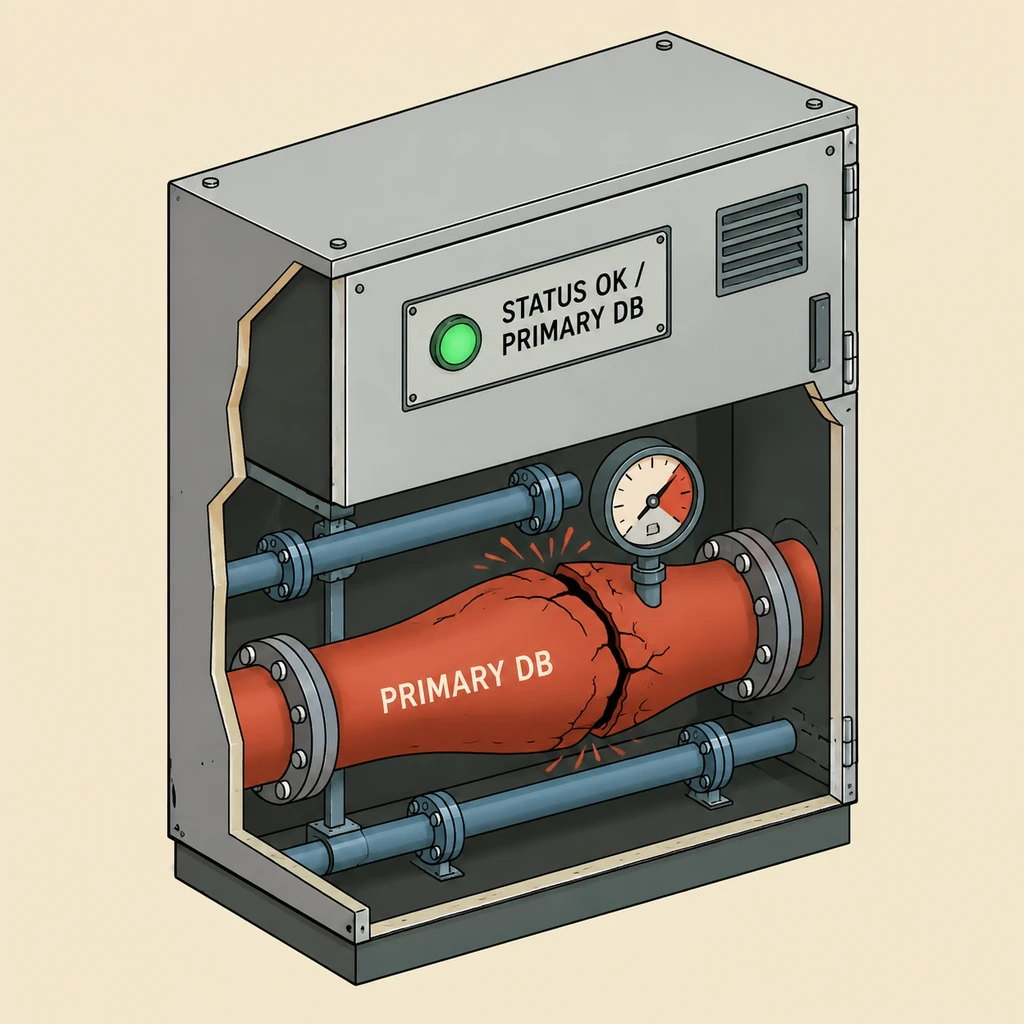
我不太买账的是状态页那套温吞的公关辞令。GitHub 基于 Atlassian Statuspage 构建的状态通报,从头到尾只用了性能降级(degraded performance)和延迟(delays)两个词,连个具体失败率都没给。
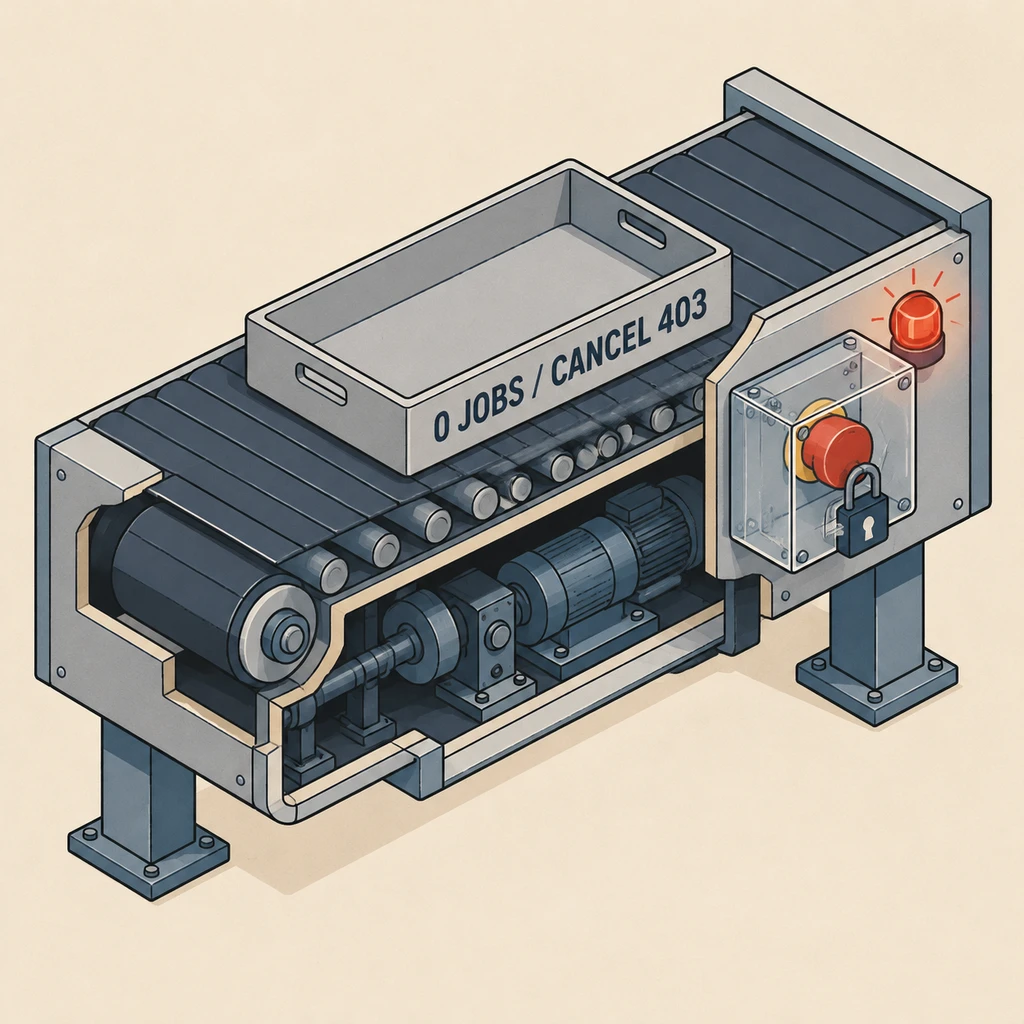
但在一线开发者的屏幕前,这套系统当时已经陷入了状态机紊乱。社区实测反馈了三种典型症状:Pages 工作流卡在排队状态、界面显示 0 个 job 且根本无法点击取消;外层工作流已经显示运行结束,但里面的子 job 依然挂在排队队列里;好不容易等任务失败,尝试点击重新运行(re-run),系统直接甩出内部服务器错误或 403错误。
这就是宏观统计与微观体验的割裂。对平台监控来说,队列没丢消息、只是消费变慢,自然算作延迟;但对指着 CI/CD 流水线发版上线、修线上 bug 的工程师来说,任务卡死且剥夺取消权限,就等于研发交付直接停摆。你甚至没法通过手动清理旧任务来给新任务腾位置。
为什么总是这三兄弟一起挂
每次 GitHub 自动化底座出事,Webhooks、Actions 和 Pages 几乎总是绑在一起进病房。这不是巧合,而是它们在底层架构上本来就是一根绳上的蚂蚱。
现在主流的 GitHub Pages 构建与部署,底层直接跑在 Actions 流水线上;而 Actions 工作流能不能被唤醒,完全仰仗代码仓库状态变更时产生的内部事件和 Webhooks 触发。当底层事件总线、消息队列或核心数据库出现拥塞,第一张倒下的多米诺骨牌是 Webhooks 投递滞后,紧接着 Actions 调度器拿不到完整上下文或写不进状态,最终体现为 Pages 部署大面积卡死。
更值得留心的细节在 18:06 UTC 的那次更新里:除了这三兄弟,代码搜索和界面实时更新(live updates)也同时报错。而且就在不到 3 小时前(14:21 至 14:30 UTC),GitHub 刚刚因为某组件暂时过载导致 Issues 和 Pages 错误激增。
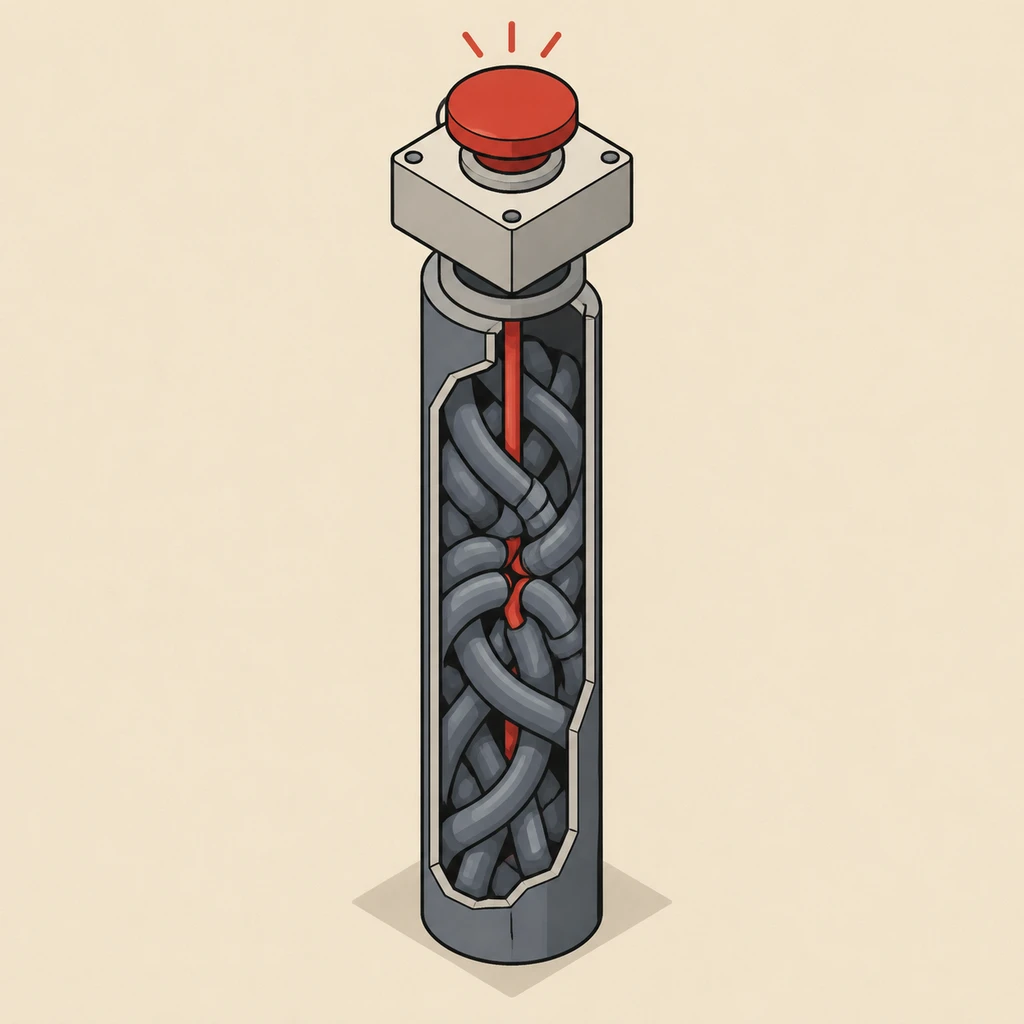
古人讲,病加于小愈。下午两点半那场只持续了半小时的组件过载,到底是彻底修好了,还是只做了表面限流、结果在三小时后酿成了更大范围的队列雪崩?当主状态库或事件分发层承压时,不仅自动化流水线转不动,连开发者点一下取消按钮、或者重试拉取权限校验(报 403)的轻量级控制请求,都会因为共用底层连接池而被一并拒绝。
把控制面和数据面绑在同一条过载链路上,出事时连拔电源的手都会被卡住。
九月旧疾未愈,十月再添新账
GitHub 在通告末尾照例留了一句,详细的根本原因分析(RCA)随后奉上。按照 GitHub 的惯例,单次状态页不会深挖架构丑闻,真正的复盘要等到次月中旬发布的月度可用性报告。
截至 10月30日,我们能看到的最新复盘是 10月14日 发布的《2026年9月可用性报告》。恰恰是这份报告,把 GitHub 底层基础设施的软肋交了底。
就在一个半月前的 9月13日,GitHub 刚刚发生过一起严重影响 Actions 等核心服务的数据库过载事故。当时的复盘查明,一个后台清理任务只监控了只读副本(replica)的延迟,却完全忽略了主库(primary)的负载,直接耗尽了数据库连接;更致命的是,系统缺乏合理的超时机制,叠加客户端反复发起令牌创建重试,形成典型的重试风暴,把本就喘不过气的主库彻底打满。
无独有偶,9月28日 另一场导致 Copilot 代码审查结果消失的故障里,某项服务变更向客户返回了不完整的数据,却向系统报告成功完成,导致监控大盘一片绿灯,根本没察觉功能已经失灵。
把 9 月这两起事故的病根拿过来对照 10月30日 的症状,简直像同一个模子刻出来的:
- 监控盲区与状态失真10月29日 定时工作流就已经无法触发,官方状态页却毫无反应;10月30日 工作流显示已结束,里面的 job 却还卡在排队。
- 过载保护与重试反噬9月13日 刚吃过数据库连接耗尽与重试风暴的亏,承诺要做容量感知后台处理、减少重试、增加数据库超时;结果 10月30日 下午先来一次组件过载,三小时后又来一次持续 42分钟 的全链路拥堵。
- 风险.重度依赖 GitHub Actions 与 Webhooks 的研发团队和第三方 DevOps 工具商,在底层队列拥堵时不仅会遭遇交付停滞,还会面临外部系统状态失步与任务无法手动终止的死锁风险。
当一家平台把全球开发者的代码托管、CI/CD 算力调度、静态页面托管乃至 AI 代码审查全部收拢进同一个巨型单体生态时,任何一处底层数据库或消息总线的抖动,都会沿着高耦合链路放大成全局停摆。10月30日 这一天两崩到底是不是 9月 数据库旧疾的复发,得盯紧 11月中旬 出炉的《10月可用性报告》怎么交差。