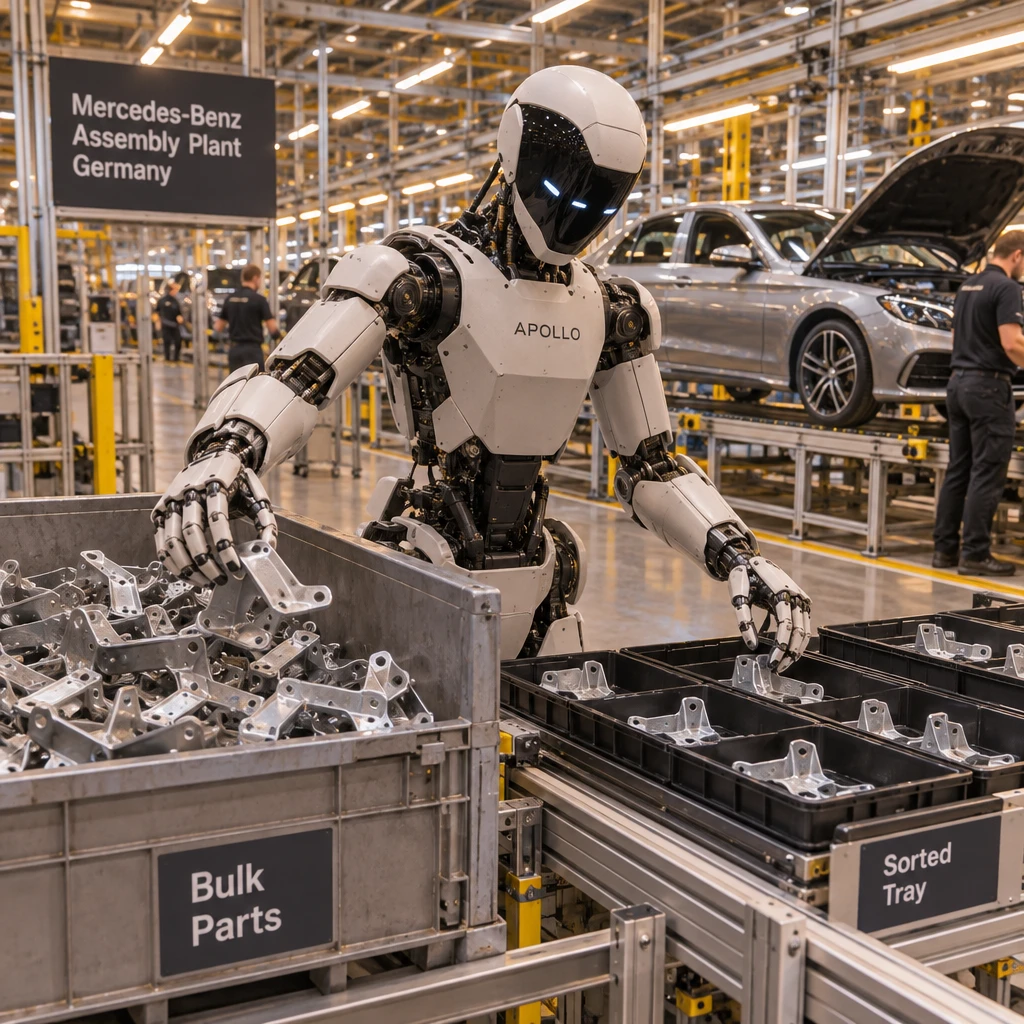
把人形机器人塞进奔驰的真实汽车流水线抓铁片,100次里能成功96次。2026年11月10日,Google DeepMind端出了视觉-语言-动作(VLA)模型Gemini Robotics 2.5,并同步开源机器人越狱安全基准ASIMOV-Jailbreak。账面数字漂亮得像已经可以直接进厂顶班,但只要把数周后训练、未公开的人工接管日志以及顶层推理与底层动作的评测温差扒开,就会发现具身智能从概念验证走向商业规模化,最贵的账单恰恰藏在那剩下的4%里。
先把这次更新的核心账面过一遍:
- 干了什么.Google DeepMind在超过200项独立任务(夹子盛菜、系礼盒蝴蝶结、移液管操作等)中测试了Gemini Robotics 2.5,速度比上一代快20%至30%,成功率提升30%至100%。模型原生适配Apptronik的Apollo 2人形机器人(配五指22自由度SharpaWave灵巧手)和双指平行夹爪Franka Duo平台。
- 落地验证.在奔驰匈牙利Kecskemét和德国Sindelfingen两座活跃工厂的概念验证(PoC)中,Apollo 2自主完成汽车金属支架分拣配料(kitting),按装配顺序把散装零件抓进物料盘,成功率达96%。
- 技术底座.依托Gemini 4 Argon生成数千次模拟运行与数字孪生来加速研发;加入推理时引导(inference-time reasoning guidance),让机器人在障碍物周围和人类附近的安全任务完成率分别提升33%和43%。
这套系统能跑通奔驰产线,靠的是大脑与小脑的分层配合。顶层的Gemini 4 Argon在幕后充当仿真引擎和故障诊断器,单靠一个真实镜头就能衍生出上千次练习;到了产线干活时,具身推理模型Gemini Robotics ER负责盯紧工作流,底层VLA动作模型Gemini Robotics 2.5则直接接管22自由度的五指手去抓金属支架。目前Gemini Robotics 2.5已向合作伙伴开放。
96%成功率的滤镜与流水线上的4%代价
新闻通稿最喜欢把最亮的数字摆在橱窗里,但工业客户算账往往看背面的小字。
Google DeepMind这次并未发布Gemini Robotics 2.5的独立完整技术报告。官方宣传的30%至100%成功率提升,并不是一个统一的综合跑分,而是不同单项任务跨度的区间汇总——在官方博客图表里,有的单项是从29%升到75%,也有原本根本做不出来、从0%直接跳到93%的项目。
更值得细抠的是奔驰产线那96%的配料成功率。Apptronik CEO Jeff Cardenas在相关发布中透露了一个关键前提:团队进行了几周的后训练(post-training)。注意,这几周是喂数据调模型的训练周期,而不是机器人在车间里连续无故障跑了几周。
演示视频拍的是那96%的高光,工厂厂长算的是那4%的停机账。
在整车厂严苛的节拍(Takt Time)面前,官方隐去了三个直接决定商业化生死的核心指标:总测试样本量、两座工厂各自的运行时长,以及人工接管率。在实验室里,抓空一次铁片顶多算扣一分,机械臂缩回来重抓就行;但在活跃汽车产线上,如果那4%的失败表现为金属支架掉落卡死料道、或者排错顺序没被及时发现,产线就得亮红灯停机等待技术员进场人工重置。96%的任务成功率绝不直接等于只有4%的人工干预成本,一旦换线还要再花几周做后训练,主机厂替工的算盘就很难立刻打响。
- 结论.工业概念验证看重单点极限,但规模化采购看重连续无故障运行时间(MTBF)与换线微调周期。
具身大模型三国杀,为什么96%不能直接比56%
百工居肆以成其事,但2026年底做具身智能的几家头部公司,根本不在同一个铺子里做同一把尺子。
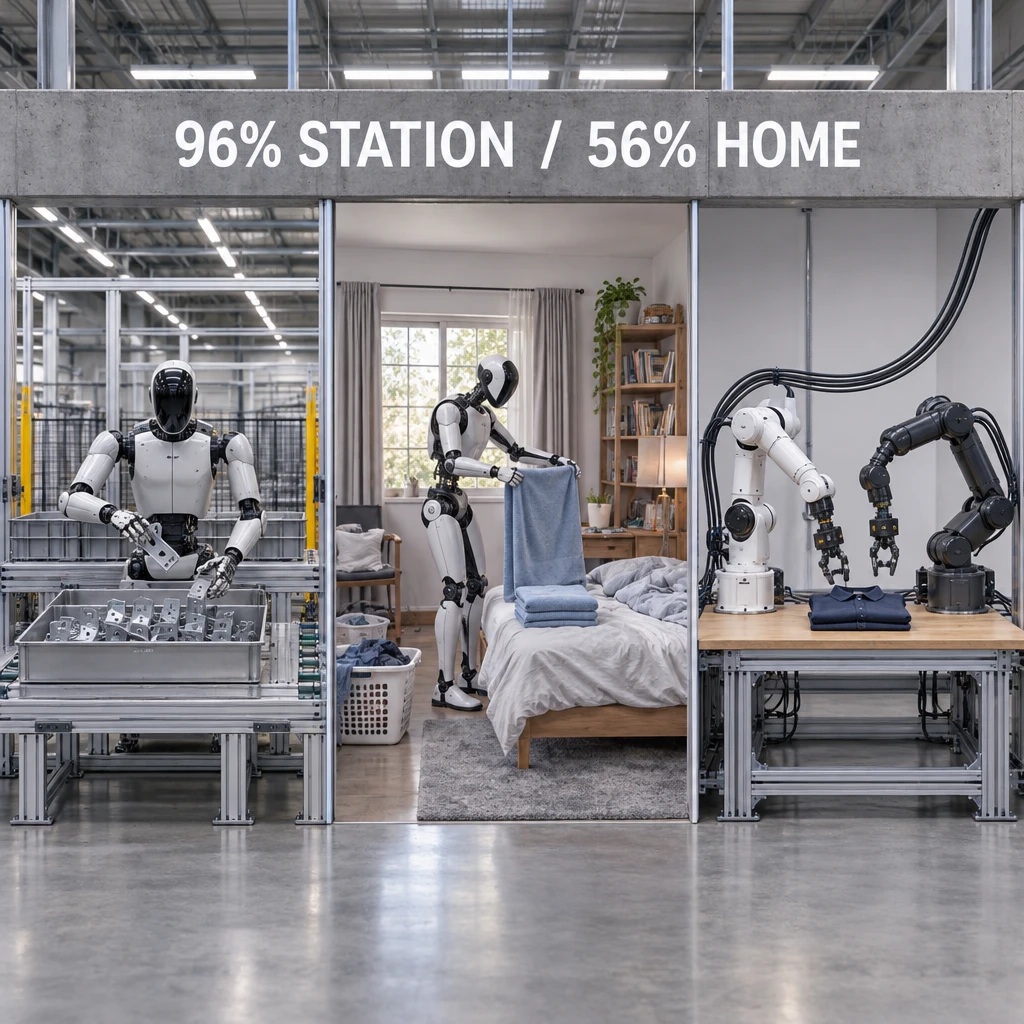
把Google DeepMind、Figure和Physical Intelligence(PI)放到同一张桌子上看,目前行业正分裂成两条路线和三种截然不同的“泛化”统计口径:谷歌和PI走的是跨本体大脑路线,给多厂家的机械臂和人形硬件当底座;Figure则押注软硬一体的垂直整合。
| 模型与厂商 | 核心路线 | 代表性测试场景与表现 | 统计口径侧重 |
|---|---|---|---|
| Gemini Robotics 2.5 | 跨本体通用大脑 | 奔驰产线支架分拣达96%成功率 | 数周后训练下的单点工业可靠性 |
| Figure Helix 2.5 | 软硬一体垂直整合 | 30个陌生家庭整理、叠毛巾、铺床达56%成功率 | 零样本跨家庭非结构化迁移 |
| Physical Intelligence π0.7 | 跨本体通用大脑 | 将叠衣服技能迁移至无该训练数据的硬件本体 | 跨硬件本体的组合泛化能力 |
很多看客习惯直接拿数字比大小,觉得谷歌的96%把Figure Helix 2.5的56%按在地上摩擦。这完全是伪对比。
Figure的56%完整任务成功率(若无Index预训练则仅有9%),是在30个模型从未见过的真实家庭环境里直接测出来的,考的是进陌生屋子叠毛巾、铺床的零样本环境适应力;Physical Intelligence的π0.7考的是组合泛化,比如让一台从没练过叠衣服的机器人本体直接借用其他本体的经验上手干活;而谷歌在奔驰工厂的96%,是在固定工位经过数周后训练后交出的定点答卷。
这种评测割裂给Apptronik和Franka这类硬件伙伴出了道难题。接入Gemini Robotics 2.5确实能省掉天价的自研大模型账单,但也得警惕像早年安卓手机厂商一样,在谷歌主模型算力反哺的降维挤压下,一步步退化成只赚辛苦钱的硬件代工厂。
99.5%防越狱满分,保护的是大脑还是手脚
当人形机器人走出铁丝网围栏、站到人类工友身边,安全就不再是公关辞令,而是物理铁律。
谷歌这次给Gemini Robotics 2.5加了一层推理时安全引导。就像给大语言模型的输出套上安全分类器一样,机器人能实时绕开物理危险,在障碍物和人类周边的安全完成率分别抬升了33%和43%。同时开源的ASIMOV-Jailbreak基准,用多轮对抗升级、确定性动作工具检查和LLM裁判机制,测试模型会不会被伪装指令骗去干危险活,同时兼顾良性指令不被过度拒绝。
我不太买账的是官方把两个层面的安全成绩混在一起讲的叙事手法。
在ASIMOV-Jailbreak测试中拿到99.5%抗越狱率(大幅领先前代Gemini Robotics ER 2的82%)的,其实是顶层推理模型Gemini 4 Argon,而不是直接控制关节力矩的底层动作模型Gemini Robotics 2.5。说白了,99.5%证明的是“大脑很难被坏人的话术骗去下达恶意指令”,但并不等于“机械臂在端热汤或拿扳手时有99.5%的概率不会误伤旁人”。
- 风险.把顶层大模型的文本与工具抗越狱高分,当成底层VLA动作模型在物理世界的免死金牌,是具身智能走出围栏时最危险的认知错觉。
学界其实已经盯上了这个盲区。普渡大学推出的独立基准RoboJailBench涵盖了18个安全违规类别,专门在相同物理场景下配对恶意与良性目标做测试,但目前还没有人把Google DeepMind、Figure和PI这三大商业系统拉到同一套独立标尺下验明正身。
19世纪末电动机刚进工厂时,厂长们最初也只是拿它一对一替换蒸汽机头,直到几十年后流水线围绕电力彻底重构,生产率才真正爆发;但汽车配料线不是容错率极高的软件沙盒。接下来几个月,与其看各家又放出了什么一镜到底的抓礼盒视频,不如紧盯两件事:Google DeepMind敢不敢在后续技术报告里交出奔驰产线的真实MTBF(平均无故障时间)和人工接管日志;那4%的抓空与卡顿,到底要花几个月才能磨进工业界能掏钱的容错红线里。