2026 年 9 月 15 日,开发者 Ori Bernstein 在 openbsd-tech 邮件列表公开了一份早期的内核补丁,将原本为 Plan 9 分支 9front 编写的写时复制(COW)文件系统 GEFS 移植到了 OpenBSD。作者在邮件开头直截了当交了底:短期内绝不申请进入内核主干,当前代码极其粗糙,在异常情况下必然丢数据。
在动辄数十万行代码的现代文件系统面前,这份补丁最扎眼的地方在于体积极小。整个移植版在 OpenBSD 内核中不足 9,000 行代码。它既没有走 OpenZFS 那种庞大复杂的全功能路线,也没有退守回 40 年历史的传统磁盘布局,而是用一套精悍的现代设计,在两套哲学迥异的系统之间强行搭起了一座试验桥。
扁平键值与 Bε 树:GEFS 凭什么这么轻
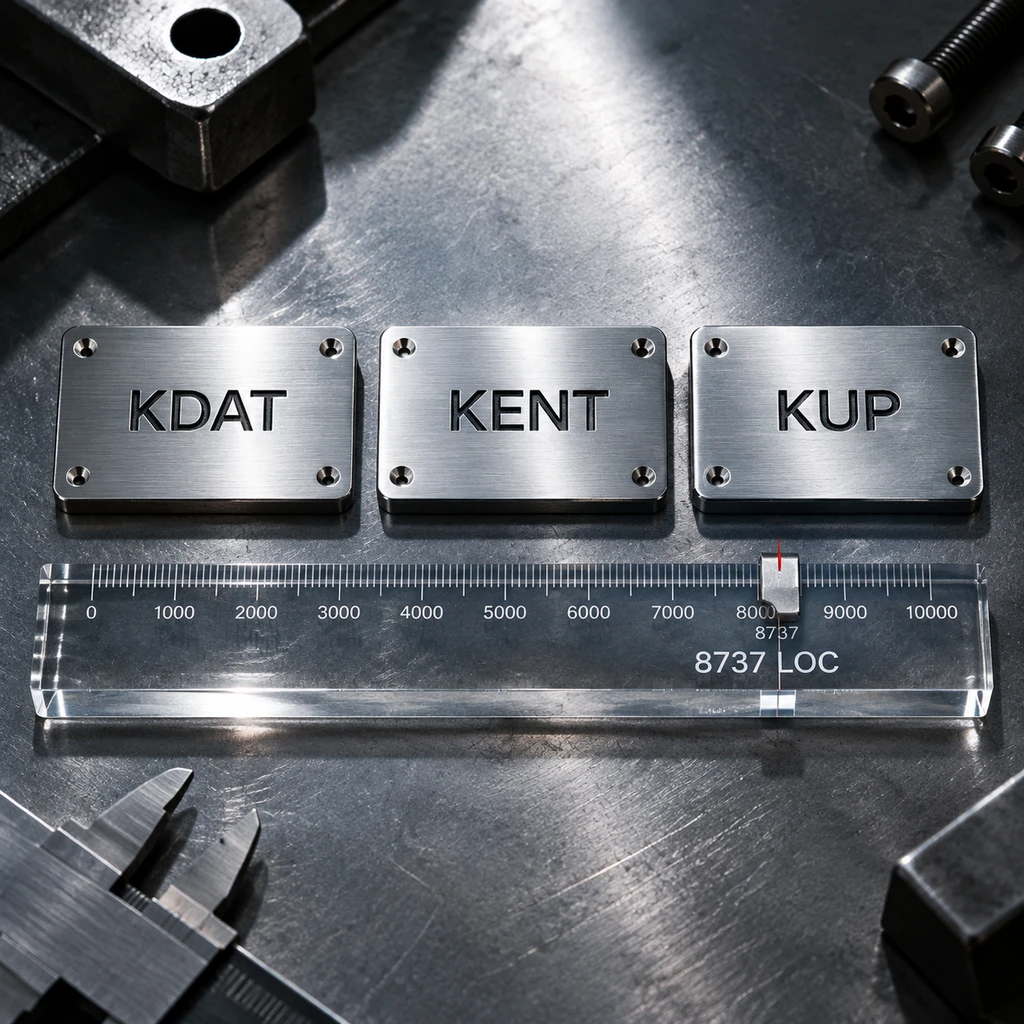
在 2026 年的 FOSDEM 上,Ori Bernstein 就曾详细展示过 GEFS 的设计原貌。它的核心实现源自 9front,最初代码规模仅有 8,737 行源代码。它之所以能把体积压到主流现代文件系统的零头,是因为它彻底抛弃了 Unix 传统存储里那套由 inode、多级目录树与间接块构成的经典结构。
GEFS 底层建立在 Bε 树森林之上,把整个文件系统抽象成了一个扁平的键值存储空间。Bε 树的关键特性在于节点内部自带写入缓冲区,所有元数据变更和写入操作先暂存在缓冲区内,随后批量向下刷入子节点,大幅平抑随机小写入带来的磁盘寻道开销。存储空间被划分为不同的 arena 区域,并在数据块、基准块与叶子块之间轮询分配,借此分散写入热点。
在这种设计下,系统核心键类型只有三类:数据块指针 Kdat、文件元数据 Kent 以及父目录条目 Kup。读取目录内容时,不再需要沿链表解析目录项,而是直接使用唯一标识 QID 前缀在树中进行范围扫描。
在数据安全方面,GEFS 依赖影子写入与原子根发布来实现崩溃一致性。系统默认的快照提交间隔大约为 5 秒,一旦遭遇突发掉电,最坏情况仅是丢失最近约 5 秒内未持久化的数据,但文件系统的整体树状结构绝不会损坏,彻底告别了开机漫长扫描。每一个块指针都由物理地址、校验哈希和诞生世代组成三元组,能有效识别静默数据损坏;只是它本身不具备自愈修复能力,检测到错误后仍然需要依赖外部冗余或冷备份。空间释放则借鉴了类似 ZFS 的死块列表机制,由双世代延迟回收协议保护只读并发访问,省去了昂贵的全盘扫描。
当 Plan 9 的极简撞上 POSIX 的现实
虽然 GEFS 在原生环境里逻辑自洽,但把它搬进 OpenBSD 的过程,却揭示了极简架构在面对工业级操作系统时的严酷摩擦。作者在邮件中坦言,目前的代码基本上是直接复制粘贴过来维持两边逻辑押韵,但两套系统的底座存在巨大的语义裂痕。
Plan 9 的设计哲学高度纯粹,依赖 9P 协议和独有的进程错误捕获机制;而 OpenBSD 遵循严密的 POSIX 规范、vnode 生命周期管理与严格的内核编码约束。这种断层直接反映在目前公开的补丁里:
- 错误处理路径被大量注释,原作者明言 9front 的错误处理方式在 OpenBSD 内核里完全不能被接受。
- 内核代码中残留着全局变量,导致系统目前根本无法同时挂载两个 GEFS 分区。
- 缺乏原生用户态工具,目前要格式化或检查磁盘,甚至只能在虚拟机里启动 9front 来操作。
- 缺少针对 OpenBSD 的本地回归测试集,POSIX 约束里的硬链接计数、kqueue 文件变更通知、NFS 挂载钩子等特性均处于待补全状态。
极简代码往往是在理想假设下写就的,而现实工程的厚度全堆在脏活累活里。
目前 GEFS 的磁盘格式仍处于可能调整的实验阶段,大文件删除缓慢等底层短板也尚在优化。正如古人所云,行百里者半九十。把一套文件系统的读写主干跑通只需几千行代码,但要把上百种边界错误、锁竞争和异常断电路径全部缝合进生产内核,付出的代码量往往会翻上数倍。
传统固守与现代特性之间的缝隙
OpenBSD 社区对现代文件系统的饥渴已经持续了多年。系统核心存储长期依赖古老的 FFS 与 FFS2,配合 softraid 提供块级镜像。这套方案虽然极其可靠,代码也经受了数十年苛刻审计,但在现代断电场景下,漫长的 fsck 恢复过程让不少边缘设备和服务器运维苦不堪言。更现实的痛点在于配额控制:当前 FFS2 的配额仅限于传统的用户和组维度,根本没有类似现代存储的 dataset、独立子卷与快照配额机制,面对体量庞大的现代构建目录往往缺乏精细隔离手段。
引入功能完备的 ZFS 显然不符合 OpenBSD 追求极致简洁与高度可审计的组织惯性。ZFS 庞大的代码体量、高昂的内存开销以及许可证层面的隔阂,使其几乎不可能被纳入 OpenBSD 主树。
- 提醒.当前公开的 GEFS 补丁仅供内核研究与协议讨论,缺乏完整的 VFS 错误处理与用户态工具,任何生产或重要存储环境均严禁尝试。
GEFS 的意义正是在这里浮现。它不是试图重新造一个全知全能的 ZFS,而是通过学术界的 Bε 树结构与精炼的工程剪裁,证明了现代写时复制与崩溃安全特性可以被收敛在万行以内的代码空间里。作者没有急于把代码推进主干,而是早早交出补丁直面缺陷,正是为了让社区在底层结构固化前厘清一致性协议与接口胶水层。这场从 Plan 9 漂流而来的实验能不能在 OpenBSD 上真正着陆,不在于概念有多精巧,而在于后续漫长的故障注入测试里,它能否耐得住现实世界那些极其难看的硬件异常。