大模型究竟能在参数与上下文中记住多少事实,长期以来被笼统归因于规模法则与参数堆叠。2026 年 10 月,研究者 Alex Wang 发布技术长文,从联想记忆与检索信噪比的微观视角重构了神经网络演进逻辑:在 Key 向量维度仅为 64 的极简基准下,线性外积存储的记忆容量仅约为 64,引入平方激活的 MLP 跃升至约 2,700,而带有指数级非线性的自注意力机制理论容量一举突破 120 万。
这项推演直击大语言模型的核心秘密:Transformer 并非不可捉摸的黑盒特征提取器,而是一套层层对抗噪声、压制非目标记忆干扰的联想存储器。然而这种容量暴涨并不是无代价的压缩魔法,而是大模型在架构设计上面临的一场工程置换。
线性外积的正交墙与梯度的本质
经典神经网络处理记忆的最简单方式是矩阵外积求和。当我们将输入键值对叠加进权重矩阵时,检索过程等价于用查询向量与所有存储键比对相似度,再按相似度加权输出目标值。
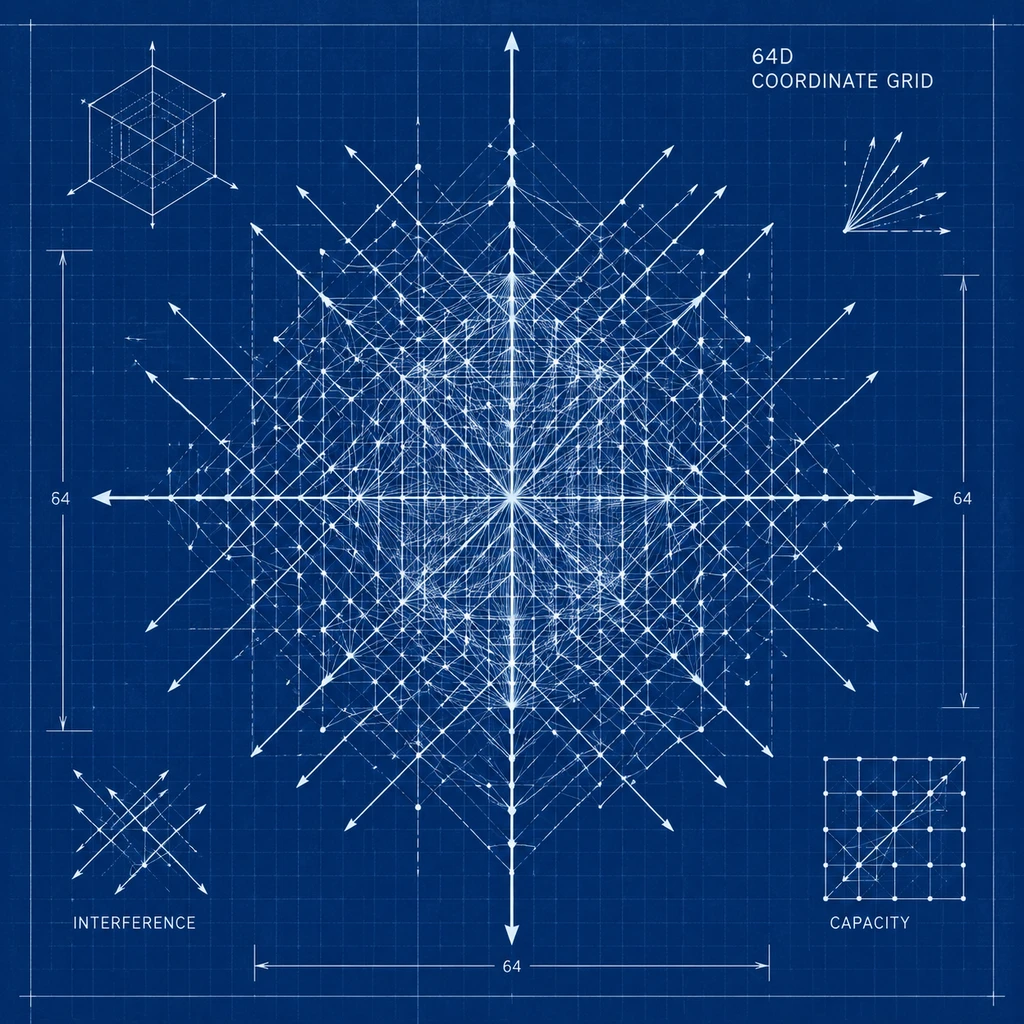
这种线性存储方式有着坚硬的几何天花板。在 64 维空间中,相互垂直的正交方向至多只有 64 个。一旦存入的事实数量超过键维度,非目标记忆的微弱投影便会像随机游走一样层层累加,形成致命干扰。理论推导表明,当干扰强度与目标信号等大时,线性外积层的理论容量仅约为 dk=64。即便通过最小二乘法进行协方差白化处理,消除共享方向的重叠,最优线性存储器的容量极限也仅仅停留在 2dk=128。
更为关键的理论联结在于梯度下降与注意力的底层统一。正如 Irie、Csordás 与 Schmidhuber 在 ICML 2022 所证实的,常规梯度下降在反向传播更新参数时,本质上是在向权重矩阵累加历史输入与负梯度的外积。换言之,普通线性层的前向计算,等价于对模型全部训练历史做未归一化的点积注意力。这证明了静态参数与动态上下文在记忆机制上本就是同源的数学结构。
非线性过滤:从平方激活到百万级自注意力
如何打破 64 维的正交限制?核心手段在于抑制低相似度键带来的干扰。
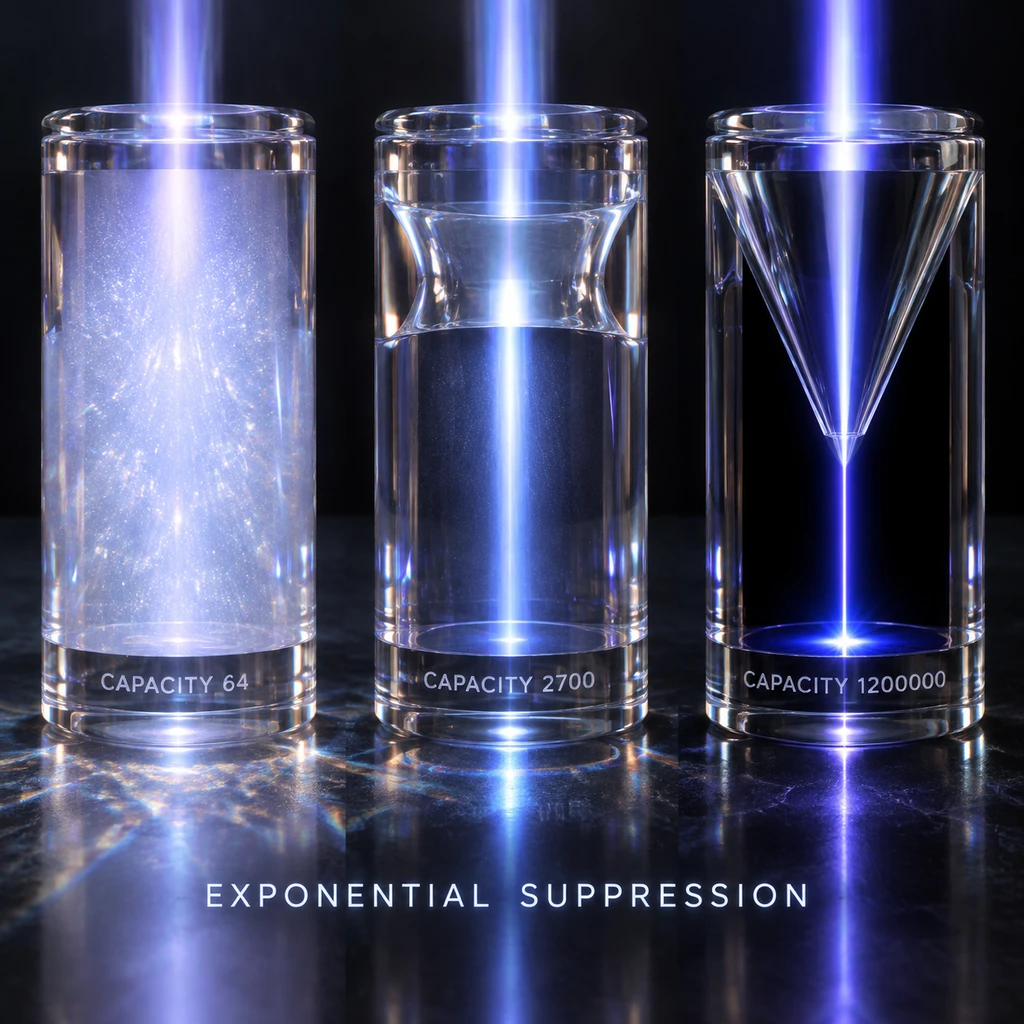
多层感知机(MLP)通过引入非线性激活函数实现了第一次飞跃。当模型采用平方激活(Squared-ReLU)时,低相似度项被大幅衰减,负相似度直接归零。相似度为 0.1 的噪声项在平方后萎缩至 0.01,而满分项依然保持为 1。在 dk=64 条件下,Squared-ReLU MLP 的记忆容量公式约为 2dk²/3,理论容量直接跳跃到 2,700 左右。当代前沿模型普遍采用的 SwiGLU 结构,正是这一抑制机制的工程延续。
架构演进的实质,是一场不惜代价拉大目标信号与背景噪声差距的数学战争。
而 Transformer 采用的 Softmax 自注意力机制,则将这种压制推向了指数级极限。Ramsauer 等人在 2020 年对现代连续 Hopfield 网络的研究表明,连续 Hopfield 的更新规则在数学上完全等价于 Transformer 的注意力机制。当注意力锐度设为标准缩放比例(β=√dk=8)时,自注意力的信噪比容量公式为 e^(2√dk - 2) = e^14,容量一举突破 120 万。非目标记忆在指数运算面前被彻底压入底噪,系统获得了近乎无界的理论检索空间。
百万容量的代价与架构路线的物理抉择
面对 120 万这一惊人数字,行业需要保持必要的审慎。该容量推导建立在严格的玩具模型假设之上:所有键向量均为随机球面分布,查询向量能够百分之百精确命中目标键,且模型未考虑真实语料中复杂的语义重叠与长程关联。在真实大模型内部,绝对检索精度的稀释依然存在,不能简单断言模型掌握了百万量级的无损常识。
更深层的限制在于物理资源。Softmax 之所以能够实现指数级容量跃迁,是因为它放弃了信息压缩,选择在推理阶段显式保留所有序列的 KV Cache,导致内存占用随长度呈线性扩张。
- 风险.任何试图用固定尺寸状态向量压缩长文本的方案,都会因有限维度的共享干扰,撞上联想记忆的容量天花板。
这恰恰解释了当前以 Mamba、RWKV 为代表的状态空间模型(SSM)与线性注意力在真实落地中的处境。线性注意力试图通过核特征映射构建固定维度的累加矩阵,达成推断期常数级内存开销。但从联想记忆的数学本质来看,这种做法强行退回到了线性外积存储的逻辑体系中,必然牺牲对孤立事实的精准检索能力。
在“大海捞针”等长文本检索测试中,经典 Softmax 注意力凭借显式缓存带来的高信噪比,依然构筑着难以逾越的防线。大模型架构演进的终局,并非轻巧的算法替代,而是在显存开销与抗干扰能力之间,寻找一条向物理规律妥协的平衡折中点。