开源 x86 模拟器 FEX 团队在 2026 年 9 月 18 日发布了一篇名为《x86 模拟之痛》的技术长文,撕开了整个 ARM 生态运行桌面应用时始终回避的隐秘疮疤。主流认知普遍将跨架构转译的卡顿归咎于复杂的 CISC 指令集解码或 JIT 编译效率,但真正的吞吐黑洞深埋在处理器访问内存的物理契约之中:x86 强制遵守的全存储排序(TSO)与 ARM 原生倡导的弱内存序(Weak Ordering)之间,隔着一条近乎无法靠纯软件填平的鸿沟。
这不仅是一场底层工程的拆招演练,更是决定 ARM 个人电脑与掌上设备能否真正摆脱兼容假象的生死线。在重度依赖矢量指令的游戏负载中,如果要保证严格的内存一致性,执行效率可能出现近 10 倍的毁灭性下挫。为了让程序能够流畅运转,整个软件生态正被迫在架构正确性与粗暴妥协之间走钢丝。
秩序与自由的冲突:内存模型如何成为吞吐杀手
x86 与 ARM 代表了处理器一致性设计的两个极端。x86 的 TSO 模型对程序员极度友好,所有处理核心写入内存的数据全局立即可见,读取动作绝不能越过先前的写入;这种严苛的秩序以剥夺硬件微架构乱序优化空间为代价。ARM 则追求极致能效与高并发,默认放开跨核同步的即时性,允许处理器自由重排访存顺序。当模拟器试图将强规则生搬硬套到弱规则硬件上时,灾难便不可避免地降临。
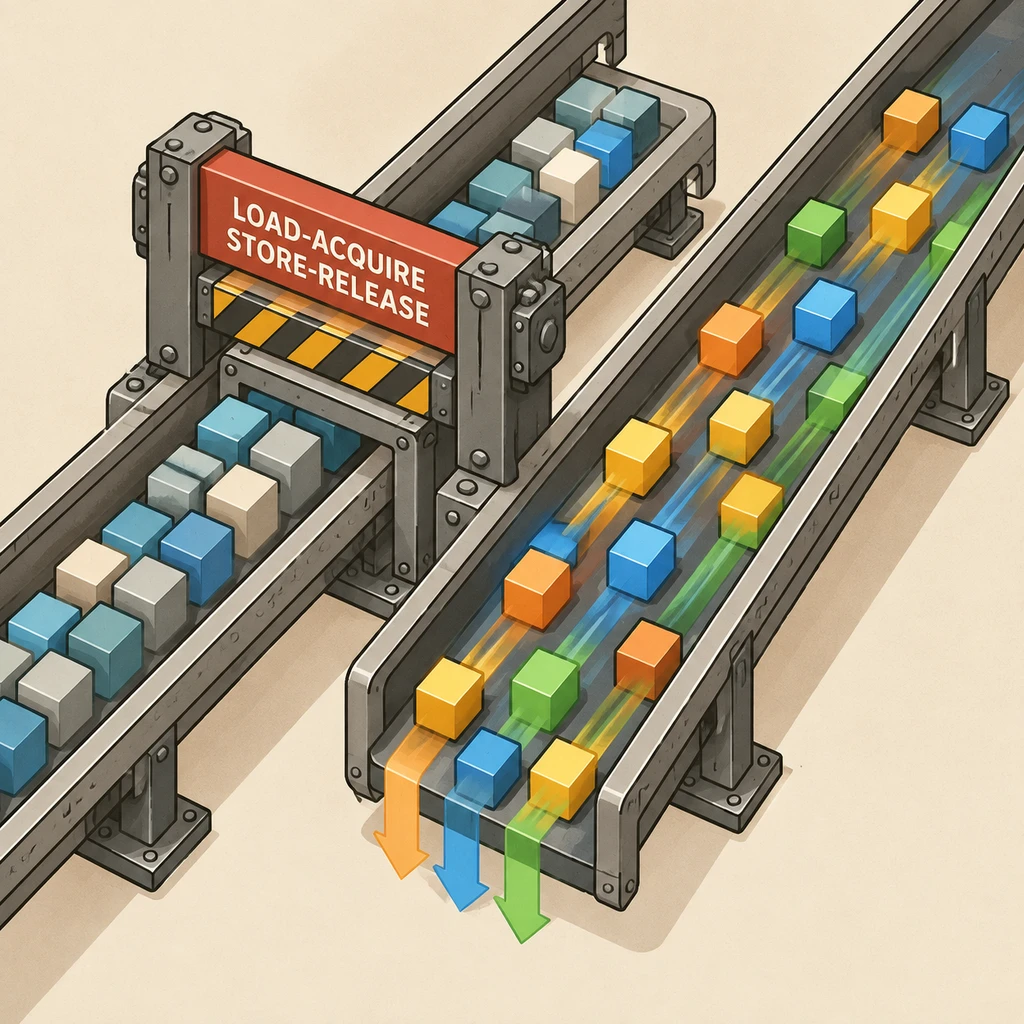
在基础的 ARMv8.0-a 时代,FEX 只能被迫把每一次普通的 x86 读取转换成 ARM 专用的获取指令(load-acquire),把写入变成释放指令(store-release)。硬件本用于低频跨核同步的特种指令,瞬间占据了整个代码流的绝大多数篇幅,导致硬件流水线彻底丧失指令重排自由。尽管后续 ARM 引入了针对性更强的 FEAT_LRCPC 指令扩展,但遇到不对齐访存时,代码仍会频繁打回低效的原型。
面对游戏负载中动辄高达近 10 倍的性能暴跌,开发者不得不走向妥协。FEX 在 2024 年 6 月发布的版本中,默认关闭了矢量及大块内存拷贝的 TSO 模拟;在 ARM64EC 环境下,更依靠微软提供的 PE 映像 volatile 元数据,选择性跳过昂贵的屏障操作。这种设计虽换取了可用帧率,却也意味着应用运行处于隐性并发竞态的阴影之下。
- 风险.关闭 TSO 带来的流畅属于兼容性假象,在老旧多线程逻辑中极易引发随机挂起与无迹可寻的数据撕裂。
四大阵营的生存取舍:硬件外挂与激进裸奔
面对内存排序这堵高墙,活跃在行业中的各个转译方案走向了截然不同的技术路线。最具决定性优势的莫过于苹果的 Rosetta 2。苹果直接在 Apple Silicon 芯片微架构内设置了 ACTLR.TSOEN 硬件寄存器,并通过 Linux 接口暴露为特定的系统控制调用,使得处理器能够一键切换至兼容 x86 的硬件 TSO 模式。
即便坐拥硬件红利,物理定律依然无法完全豁免代价。学术团队在 M1 Ultra 上的严密测试显示,仅仅激活硬件 TSO 模式,多线程 SPEC 运算负载就会平均产生 8.94% 的性能回退,在某些高度依赖共享内存的极端测试场景下,开销甚至会飙升至两倍以上。但相比纯软件模拟的万丈深渊,这种微架构层面的妥协已被证明是最优雅的路径。
无法修改芯片的开源社区则走向两极。QEMU 固守架构原教旨主义,宁肯牺牲帧率也要通过多层跨平台形式化屏障保证正确性;而备受玩家青睐的 Box64 选择了实用主义的投机,其默认配置将强内存模拟开关设为零,实质上处于彻底不模拟强内存序的裸奔状态,仅对 Steam 或特定崩溃游戏临时挂载基础屏障。FEX 则在其间艰难求索,试图以最小的正确性折损换取可用性。
终极暗礁:跨缓存行锁迫使底层系统大动干戈
如果说常规访存的一致性尚能通过削减屏障瞒天过海,那么跨越 64 字节缓存行边界的原子操作(Split-lock)则是彻底击穿流水线的阿喀琉斯之踵。在 x86 生态中,无论开发者写出的原子指令如何违背物理对齐,处理器都会通过总线锁定或复杂的缓存行锁定强行保证不发生数据撕裂;但 ARM 芯片生来便没有这层重型包袱。
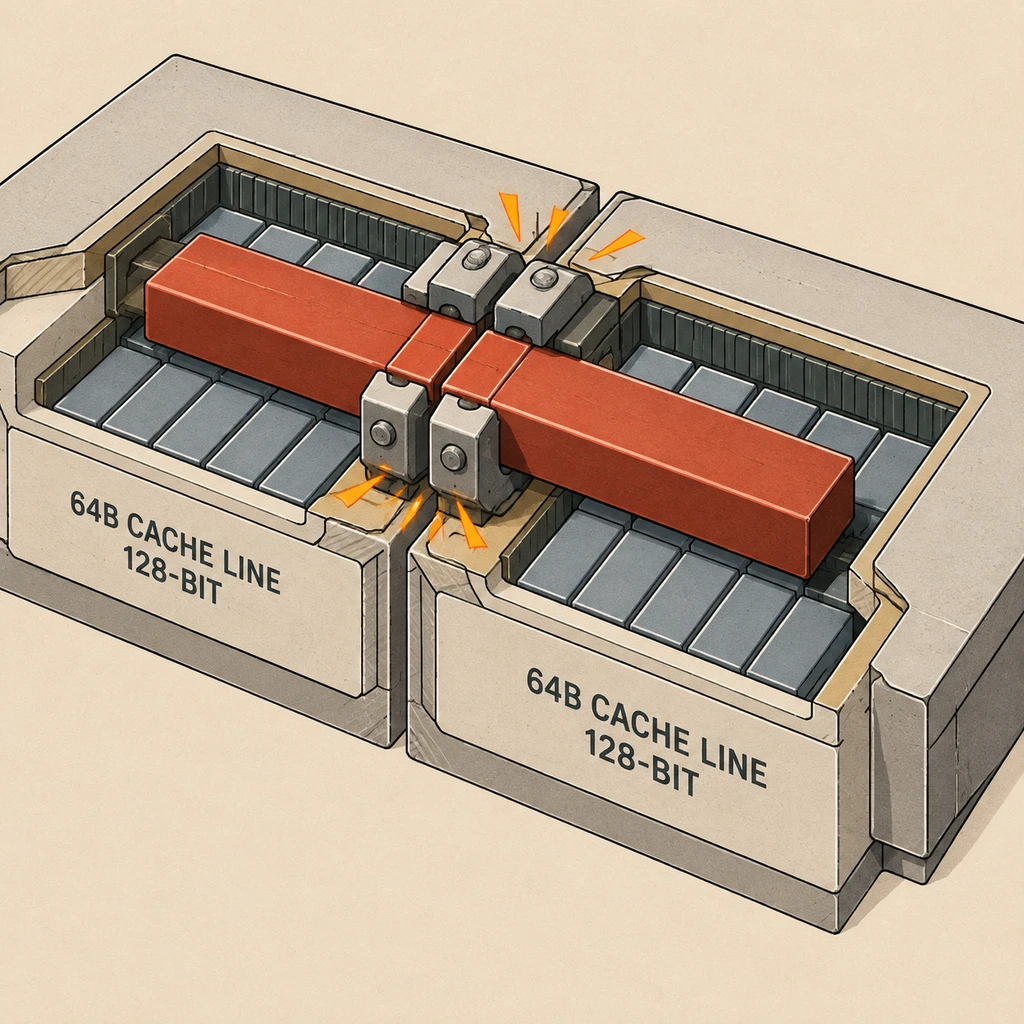
ARM 推出的 FEAT_LSE2 扩展仅仅支持 16 字节粒度以内的非对齐原子访问。一旦访存操作越过 16 字节甚至撕裂在 64 字节的缓存行两端,硬件会直接抛出对齐异常。FEX 被迫在 JIT 编译中布设空操作修补点,在触发异常后陷入用户态信号处理程序,通过极其缓慢的软件多重比较并交换(CAS)机制模拟锁行为。这种补救不仅让帧率断崖式下坠,其多 CAS 软解方案在并发理论上依然无法完全杜绝撕裂。即使是拥有专属 TSO 模式的苹果芯片,面对此类违背边界的原子操作同样束手无策。
模拟器最大的难题从来不是翻译指令,而是替几十年前的代码遵守物理世界不存在的契约。
芯片与操作系统层面的联合自救正在铺开。高通在其 Oryon 核心中优化了缓存行内部的读-改-写原子操作,大幅缓解了未对齐触发的微架构颠簸;Valve 围绕 Steam Frame 项目则被曝出借助专门的 Linux 内核补丁,绕过耗时漫长的用户态信号派发,直接在内核层快速捕获并处理非对齐原子异常。
- 建议.关注后续 ARM 架构引入原生 128 位 CASP 跨边界指令的进展,以及 Linux 统一异常处理补丁的合并节奏,这是从物理层面终结转译裂隙的唯一路径。