专为大模型与 AI Agent 定制搜索引擎的初创团队 Exa,在 2026 年 10 月 19 日正式发布 Exa 3.0 Search API 及轻量版本 Exa Lite。官方博文打出了极为激进的口号:在 8 项关键检索基准测试中全面压制 Perplexity、Brave 与 Parallel。
这场发布在公关层面制造了巨大声浪,但撕开自测跑分的外衣,行业看到的并非一场毫无悬念的代际碾压。当基准评测高度绑定自建数据集、低价模式直接切断实时抓取,且高精度模式伴随接近翻倍的任务等待时间时,Exa 3.0 带来的更像是一组充满取舍的工程妥协方案,而非搜索引擎底层能力的绝对跃迁。
阶梯定价与自测跑分的纸面神话
在此次更新中,Exa 试图用精细化的计费阶梯切入开发者市场。新产品分为三种调用规格:Lite 模式定价为 4 美元/千次请求,Auto 默认平衡模式定价为 7 美元/千次请求,针对长链条推理的 Deep Lite 模式则定价为 12 美元/千次请求,单次检索耗时约 4 秒。所有阶梯的基础费用均包含前 10 条检索结果,后续按每 1000 条额外结果加收 1 美元。
伴随计费模型落地的,还有正式进入商用阶段且不额外收费的 Dynamic Highlights 机制。官方宣称,该技术能直接为大模型提取网页核心片段,相比抓取完整网页内容可减少 95% 的 Token 消耗。
在官方公布的数据罗盘中,Exa 列出了 8 项自测指标:BrowseComp 得分 91.8%、DSQA 为 88.2%、WideSearch 为 56.1%、ATLAS 达到 42.0%、WebCode 为 75.5%、FinSearchComp 为 68.0%,以及两项未标明量纲的实体挖掘测试 Company FindAll(15.4)和 People FindAll(7.6)。依据官方构建的成本质量曲线,Lite 模式单任务成本约 0.045 美元,取得约 79 分;Auto 模式单任务成本 0.065 美元,取得约 80.5 分。
整套数字矩阵展现出极具诱惑力的性价比,但在严苛的工业级调用场景下,纸面自测与真实表现往往存在一条难以弥合的鸿沟。
第三方实测拆穿全胜幻觉
就在官方发布次日,独立基准评测机构 Artificial Analysis 于 2026 年 10 月 20 日更新了其搜索指数。该测试将 Exa Auto 配合 Dynamic Highlights 的表现与行业核心竞品展开端到端对照,结果迅速打破了所谓 8 项通杀的结论。
评测显示,Exa Auto 的最终综合指数为 80 分,与 Perplexity Search medium 的 80 分完全打平,Exa Lite 则拿到 79 分。细分指标里,Exa 仅在 DeepSearchQA 这类垂直问答场景上占据优势,而在考察全网综合浏览与信息提炼的 BrowseComp 核心项上,Perplexity 依然保持领先。
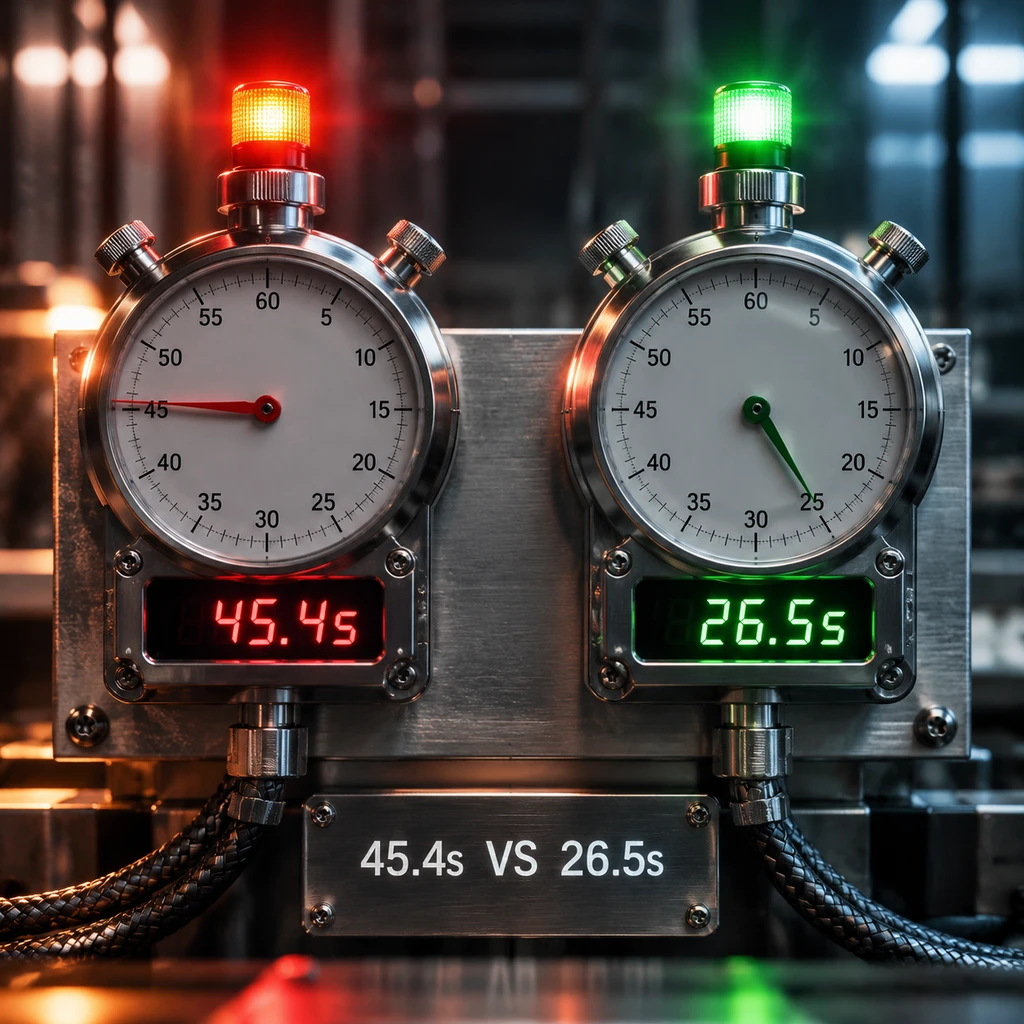
更为致命的温差来自系统吞吐延迟。在复合任务的端到端评测中,Exa Auto 的整体验证耗时长达 45.4 秒,而 Perplexity 仅用时 26.5 秒。这意味着在追求高质量输出的前提下,调用 Exa 的应用系统必须容忍将近 70% 的额外等待周期。
纸面基准的比拼可以依靠精心裁剪的任务集,但在生产环境里,延迟与时效从来不听公关宣发。
面对高延迟与平手局面,Exa 所谓的跨越式领先,在第三方独立尺标下被还原为一场局部小胜与明显迟滞并存的平局。
主场评测偏差与工程选型代价
跑分出现巨大反差的根源,隐藏在基准测试集的构建逻辑与复现透明度之中。
在 Exa 宣称全胜的 8 项指标里,ATLAS 涵盖了 547 项高度定制的表格构建任务,WebCode 则专注于特定代码与技术文档。这两项测试集均由 Exa 内部针对自身核心客户的高频查询分布专门研发。当一家搜索引擎厂商既负责铺设底层索引,又亲自裁剪测试集中的实体结构与提问方式,跑分呈现断层式优势是自然发生的数学偏向。
与此同时,可复现性存在明显的黑盒盲区。尽管 Exa 在代码托管平台上公开了支持 Bootstrap 置信区间的评测仓库,但该项目 README 明确注明其展示结果取自早期适配器的历史数据。在正式博文中,Exa 未曾公开复现 8 项对比所需的完整 API 端点参数、底层大模型的提示词策略、Token 预算上限,甚至连 Company FindAll 与 People FindAll 的计算公式与量纲单位都未予注明。
- 风险.Lite 模式虽然压低了单次请求成本,但该模式完全基于自建快照数据库,不提供任何实时网页抓取,在面对实时财报、突发新闻或变更频繁的接口文档时存在严重的时效断层。
企业在将检索组件挂载进 Agent 生产链路前,需要看清工程细节背后的暗礁:
真实业务选型坐标:
1. 成本敏感且容忍时效滞后:选择 Lite 模式(4 美元/千次),但必须规避动态强时效业务;
2. 要求深层语义对齐但对响应时间极度敏感:慎用 Exa Auto 组合,45.4 秒的长任务延迟可能直接打穿前端超时熔断;
3. 压缩 Token 开销:Dynamic Highlights 确能削减长文本开销,但切片抽取机制会在不经意间丢失长文档底部的隐性关联逻辑。- 建议.在采购企业级 Search API 时,不要采信厂商单方面公布的定制榜单,必须用自身的私域业务日志回放,在严格限定 2 秒到 5 秒的超时窗口内复测召回精度。
搜索向大模型输送养料的逻辑正在改变,但衡量基础设施的核心维度依然是时效、稳定与延迟。Exa 3.0 的登场证明了 AI 原生搜索在特定结构化任务上的解析力,但要想取代具备成熟抓取体系与快速响应通道的综合对手,仅靠一份缺少细节支撑的自测图表,还远远不够。