ElevenLabs在2026年10月20日正式发布了名为Eleven Realtime的两款端到端语音模型——v1 Max与v1 Mini。在第三方评测机构Artificial Analysis的榜单中,v1 Max以0.57秒的响应时间和Big Bench Audio(BBA)基准测试下98.8%的推理准确率,直接将GPT-Realtime和Gemini Live拉开一个身位。这家以AI配音成名的独角兽,正在试图打破大模型巨头对实时语音基模型的垄断。
这看似是一场端到端多模态的原生突围,但仔细拆解技术文档与接入规范后会发现,这更像是一场经过极致打磨的工程级联偷袭。对于正准备从OpenAI接口迁移的开发者而言,隐藏在跑分背后的架构底牌与协议限制,正带来意料之外的接入成本。
0.57秒拉爆巨头背后的指标戏法
实时语音交互领域长期受困于延迟。传统的语音识别(ASR)、文本推理(LLM)与语音合成(TTS)三段式串联管线,端到端调用通常耗时1秒以上,使得对话中的自然打断和插话极其生硬。ElevenLabs的入局,直接打破了这一延迟基线。
在Artificial Analysis的基准评测里,竞品的数据普遍在1秒以上:GPT-Realtime-2 High为1.14秒(准确率97%),GPT-Realtime-2.1 High为1.21秒(准确率96%),Gemini 3.8 Live为1.18秒(准确率92%),而带有长思考链路的Gemini 3.8 Live Extended Thinking High则达到1.35秒(准确率98%)。相较之下,Eleven Realtime v1 Max以0.57秒与98.8%的数据,在图表左上方极为抢眼。
但0.57秒并不能直接等同于用户说话完毕到听见声音的真实感知延迟。
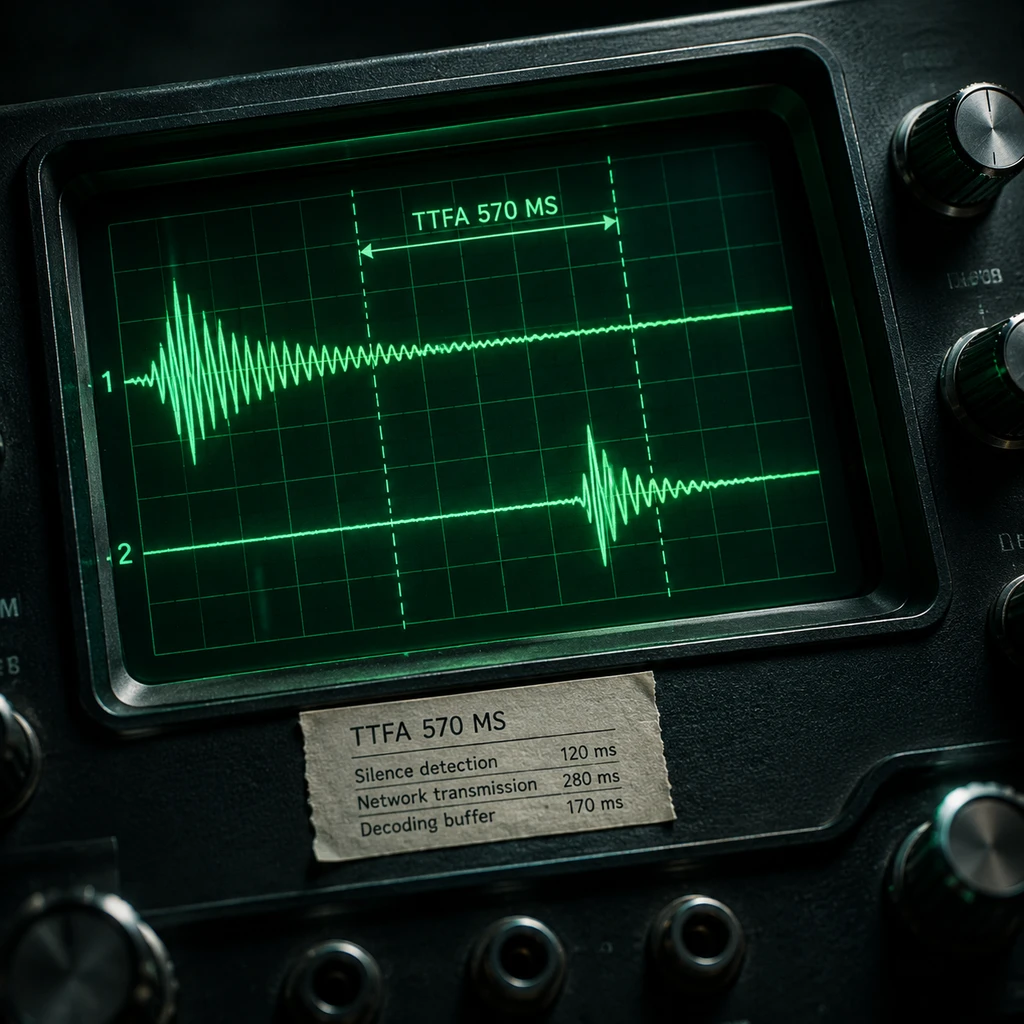
评测中的0.57秒指的是服务端首包音频生成时间(TTFA)。在真实的生产落地环境中,一次完整的语音来回必须包含客户端语音活动检测(VAD)判定静音的窗口期、网络双向传输耗时以及浏览器或扬声器的音频解码缓冲。
一个显眼的倒挂也暴露了测试口径与定位的偏差。ElevenLabs官方定位将v1 Mini定为最低延迟选项,但在官方公布的平均TTFA中,v1 Max为570毫秒,v1 Mini反而为620毫秒。不仅如此,Artificial Analysis在评价多模态语音模型时包含四大维度的综合语音指数,而Eleven Realtime因缺失完整的Agentic表现数据,至今未获得最终综合评分。官方宣传摘取了BBA与TTFA的局部坐标,放大了单项胜势。
级联架构的底牌与兼容暗礁
行业普遍期待的下一代实时语音,是类似于原生多模态的单模型端到端推理。但翻开ElevenLabs的开发者官方文档,技术细节一栏明确写着:Mini和Max的实质是级联系统(cascaded systems)的协同优化。
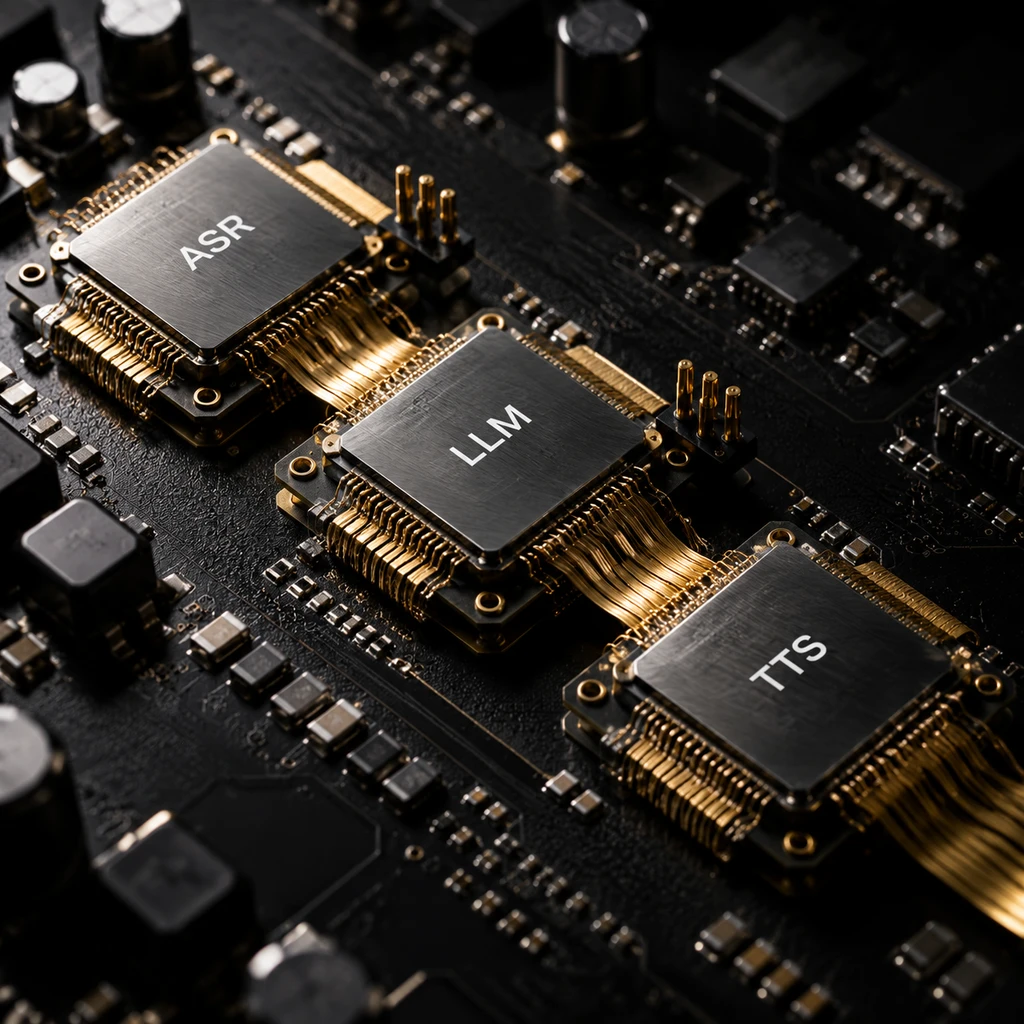
所谓的新突破,并非模型层面的统一融合,而是将识别、推理与合成三大模块在工程层压榨到毫秒级极限的流水线串联。
级联系统在复杂语境下的上下文情绪连贯度与反问意图识别上,天然存在信息在跨模块转换时的损耗。虽然v1 Mini在对话动态得分上拿到了95.8%(略高于v1 Max的94.1%),能够顺畅识别用户的语气附和并减少错误打断,但在工具驱动任务中,裂痕迅速显现。在Speech Agent Arena任务成功率测试中,v1 Max达到87.1%,而v1 Mini仅有60.3%。这意味着在执行调取数据库、调用API等客服任务时,低成本的Mini难以独当一面。
更为棘手的是工程接入。ElevenLabs官方宣称提供了与OpenAI兼容的实时API,但这里的兼容主要指事件格式与Agents SDK逻辑。在底层网络传输协议上,该接口仅开放了WebSocket连接,完全不支持低延迟交互首选的WebRTC。
这意味着已经在生产环境中基于WebRTC搭建好稳定语音架构的技术团队,根本无法实现一键平替。开发者不仅必须自建后端用于临时密钥的分发和签发,还必须在客户端手写24 kHz PCM16音频采集、重采样与实时流式播放的管道代码。原本被寄予厚望的降本替换,在工程侧先筑起了一道迁移暗礁。
- 风险.缺少WebRTC支持不仅导致既有代码需重构网络层,在弱网和移动端复杂的丢包环境下,纯WebSocket传输将更容易产生卡顿与重传延迟。
双轨计费制下的真实成本算盘
在商业落地上,ElevenLabs同时通过ElevenAgents平台和底层API提供这两款模型。但在定价上,它采用了一套混合结构:不仅按通话时长收取音频连接费,还要叠加模型处理的上下文Token费用。
| 模型版本 | 音频连接费(正常 / 峰值) | 输入 Token 费用 | 输出 Token 费用 | Agent 任务成功率 |
|---|---|---|---|---|
| v1 Mini | 0.08 / 0.16 美元/分钟 | 0.20 美元 / 百万 | 6.00 美元 / 百万 | 60.3% |
| v1 Max | 0.08 / 0.16 美元/分钟 | 1.80 美元 / 百万 | 9.00 美元 / 百万 | 87.1% |
从计费表可以看出,两款模型的音频时长底座均为0.08美元/分钟(突发峰值计费为0.16美元/分钟,且不含税)。但在Token费用上,差异拉开了数倍:Mini的输入和输出费用分别为0.20美元与6.00美元/百万Token,而Max则跃升至1.80美元与9.00美元/百万Token。
这种双轨计费彻底改变了企业的ROI测算模型。在传统的客服会话中,如果系统 prompt 包含大量的业务规则、知识库检索内容与长轮次历史记忆,一次3到5分钟的日常交互,Token费用的消耗会迅速摊薄单纯的时长成本优势。
- 建议.对容错率高、以纯陪伴或打发时间为主的轻交互,v1 Mini结合其低廉的输入成本具备性价比;但对于涉及业务办理和工具调用的场景,选型时若为了省钱强用成功率仅60.3%的Mini,带来的业务反噬将远超节省的API差价。
ElevenLabs通过精细的级联优化,在巨头林立的实时语音基模型战场打出了一记亮眼的截击。但它究竟是一次长久的路线胜利,还是一次在端到端通用模型完全成熟前的工程过渡,后续取决于其在真实弱网环境下的P95尾部延迟表现,以及打断停止延迟的最终落地数据。