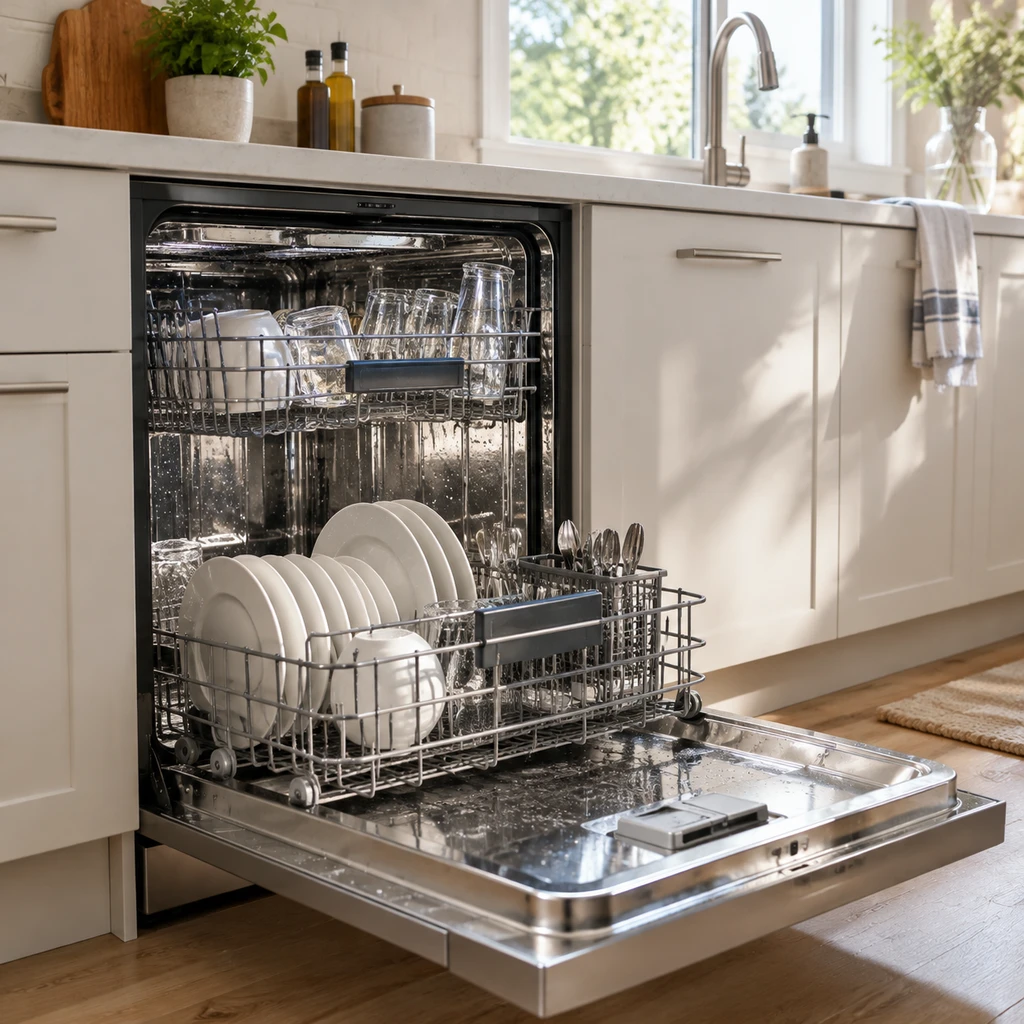
大语言模型正在被推向洗碗机这一家庭中最复杂的物理博弈场景。Composo开源了基于物理仿真的洗碗机装载评测基准DishwasherBench(内嵌游戏Spotless,当前为0.1.0早鸟版本),通过刚体动力学引擎与流体冲刷计算,试图量化大模型在几何摆放、水流遮挡与洗涤剂化学反应下的决策能力。
表面上看,这是一次通向具身智能日常落地的有趣尝试;但细究其技术底牌,它展现的既非模型对物理法则的深刻洞察,也非机器人在家务领域的实质突破。目前公开的测试记录更像一场高度辅助下的几何装箱游戏,底层赖以判定的流体物理学甚至难以自圆其说。
超越脚本的高分表象:贪心装箱掩盖了物理理解缺失
在DishwasherBench的初始测试中,模型似乎展现出了超越规则脚本的潜力。基准设置了七个难度递增的关卡,在Breakfast关卡(满分220分)中,系统内置的慎重策略脚本(careful)拿下174分,而接入的两个Azure部署模型gpt-6.1-sol分别跑出190分与188分,gpt-6-astra拿下175分;在更拥挤的Dinner party关卡(满分367分)中,慎重脚本得250分,两款模型分别拿到260分与274分。
分数的领先并没有带来对应的信服力。项目在当前的0.1.0版本中仅公开了6次偶发测试,覆盖两个并未记录明确快照版本的大模型接口。更关键的是,环境内完全缺乏真实人类基线数据,模型唯一的参照系是慎重、粗心(careless)和随机(random)这三套写死的规则算法。
模型能够实现分值反超,核心并非算透了复杂的清洗动力学,而是采取了极致的贪心打包策略。在测试中,模型装填餐具的洗净率保持在84%至100%之间,只要多塞进一件未被系统判为脏污的器皿,总分就会直接上跳。
模型的高分完全源于空间贪心填充,而非对喷淋路径或流体清洗的精准预判。
MCP接口的先验倾斜:一场被降维的3D几何题
将大语言模型在这一测试中的表现视作纯粹的视觉空间推理飞跃,是对其交互机制的误读。不同于具身智能前沿基准BEHAVIOR依赖端到端RGB与深度图像输入,DishwasherBench主要通过MCP(模型上下文协议)向模型交付高度结构化的场景数据。
在交互过程中,模型不需要从混乱的点云中推算空间几何,系统直接向其开放了list_slots等查询工具。这些接口不仅明确罗列了可用位置,还预先按照物理合理性完成了推荐排序,附带朝向姿态和放置参数。
换言之,原本极其考验机器人空间建图与接触力学的操作任务,被工程接口降维成了离散槽位的挑选问题。这种设计虽然降低了大语言模型参与交互的技术门槛,却也掩盖了当前模型在原生三维空间感知上的真实短板。
- 风险.依靠预设槽位列表取得的规划结果,难以直接迁移到缺乏标准化坐标提示的物理机械臂控制中。
脆弱的物理基准:洗涤仿真系统暴露出关键盲区
即便在降维后的沙盒里,DishwasherBench最致命的瓶颈仍然停留在物理保真度本身。一个无法准确惩罚错误摆放的评测环境,给出的分数天然缺乏权威性。
根据项目自身的验证文档,在文献衍生出的48项装载物理现象验证中仅有17项通过,有21项在影响幅度或作用方向上判定失败,另有1项场景错误、9项物理机制直接处于未实现状态。仿真对真实物理的刻画远称不上严谨。
这套系统的打分逻辑存在肉眼可见的漏洞。当餐盘倒伏相互遮挡,或者下层喷淋臂被高器皿阻挡无法旋转时,上方的盘子依然会被判定为清洁达标。至于餐具篮中最常见的勺子窝叠现象,系统大多无法给出有效扣分。当前版本唯一稳定生效的判罚依据,是容器开口是否朝下。慎重脚本与粗心脚本拉开的差距,有接近四分之三仅仅是杯碗倒扣带来的差异。
更为单薄的是其现实校准基础。该系统仅基于单次真实机洗实验(4个涂抹蛋黄的盘子在博世机型上的清洗结果),且最初的模拟推演对烤箱烘干盘残留物的预测偏低10至30倍。尽管后续通过参数拟合拉近了与同门型号公开数据的差距,但这本质上是针对已知答案的回测配平,而非物理模拟能力的真实泛化。
对于具身智能研发者而言,DishwasherBench展示了一个极其具有商业吸引力的命题,利用精细的垂直场景把复杂的通用家务拆解成可计算的离散问题。但就当前版本来看,它更像一个充满工程巧思的概念验证作品。在盘子倒下仍能判为干净、真实对照全然缺位的阶段,断言模型学会了打理家务,显然为时过早。