DeepSeek在2026年10月17日正式上线了DeepSeek V4.1 Flash 1017快照,直接替代前期版本接管官方的deepseek-flash API端点,同时在Hugging Face上以MIT协议开源权重。在OpenRouter等分发平台上,这款模型的标价被压到了输入0.15美元/M tokens、输出0.60美元/M tokens,若命中缓存,读取成本甚至降到了每百万Token 0.003美元。这绝不是一次普通的例行版本打补丁,而是DeepSeek试图用全新的结构创新,直接改写轻量模型的成本与性能逻辑。
通常认知里,后缀带有Flash或Mini的模型,无非是拿大模型蒸馏出来的妥协产物,牺牲推理深度来换取吞吐速度。但DeepSeek V4.1 Flash 1017给出的打法截然不同:它在总参数高达552B的稀疏混合专家(MoE)底座上,跑出了超越自家旗舰模型V4 Pro 0813的基准成绩。然而撕开极低的账面单价与华丽的官方跑分,第三方独立实测却撞上了严重的性能落差与长文本失效。这款激进的新模型,正在给所有押注低成本AI智能体的团队上生动的一课。
CED架构建造的非对称算力账本
要看懂V4.1 Flash的颠覆之处,首先要看懂它在底层结构上动的大手术。
长上下文推理最让部署方头疼的开销就是KV缓存(Key-Value Cache)。随着会话不断拉长,显存往往不是被模型权重占满,而是被无休止滚雪球的中间上下文吃透。DeepSeek在2026年9月10日首发V4.1 Flash概念,到了本次1017版本,正式落地了因果编码器-解码器(Causal Encoder-Decoder,简称CED)架构。
这个网络总共包含40层Transformer,切分为20层因果编码器与20层解码器。巧妙的设计在于,它不需要解码器逐层从头运算上下文信息,而是直接通过最后一层编码器的隐状态,投射出解码器所需的全局KV缓存。配合SWA Bounded Replay机制,模型把全局KV内存压榨到了每Token仅890字节,相较上代Flash直接砍掉了约四分之三的缓存空间。
更激进的是激活策略。在总计552B(Hugging Face平台自动化元数据检测显示为763B,双方统计口径存在分歧)的超大底座中,输入阶段(Prefill)仅激活区区8B参数,输出阶段(Decode)激活16B参数。这一非对称切割把庞大上下文塞入模型的计算代价降到了谷底,也是OpenRouter上加权平均实际输入价格能跑出0.0132美元/M超低单价的核心技术支柱。同时,它放弃了此前V4 Flash Vision Exp的外挂视觉方案,直接在预训练初始阶段将图文Embedding混合训练,实现了原生多模态输入。
决定智能体生死的不止每Token单价,更是上下文拉长时的显存消耗速度。
- 结论.非对称激活避开了长提示词的高算力惩罚,让百万级上下文的输入计费首次具备了大规模工业化分发的商业可能。
跑分逆袭旗舰背后的独立评测温差
低价通常伴随着平庸,但DeepSeek官方公布的成绩单却宣称1017版本全面超越了此前的旗舰款V4 Pro。
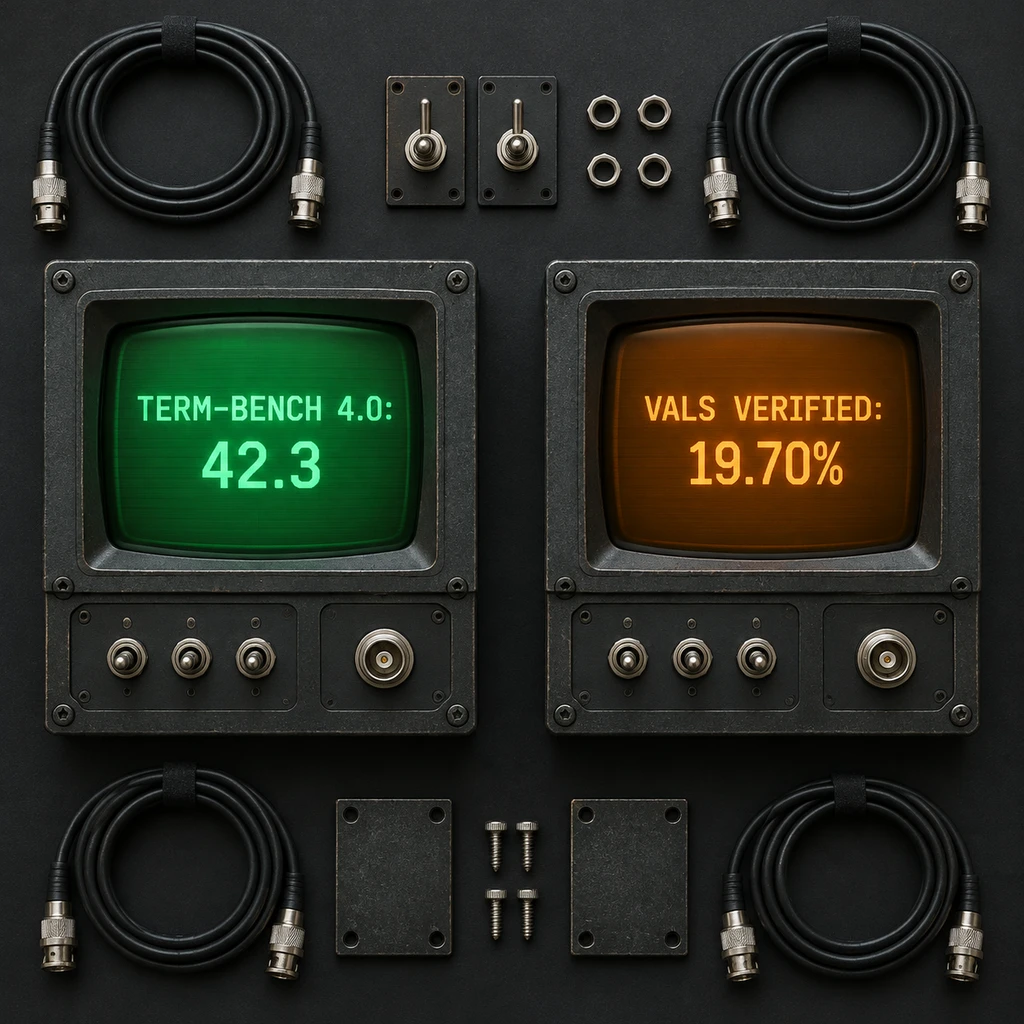
官方数据显示,相较9月初始版本,1017快照在代码与终端指令上进步明显:Terminal-Bench 4.0从31.2升至42.3,DeepSWE v1.1代码修复基准从74.2升至77.0,ProgramBench也从20.3涨到了29.1。评测机构Artificial Analysis的数据也给出了佐证:V4.1 Flash的综合智能指数达到39分,高过V4 Pro的36分;而在生成速度上,Flash凭借175.9 tokens/s的吞吐达到了Pro(78.8 tokens/s)的2.2倍,综合任务成本直接降低了60%(0.27美元对0.67美元)。
但细看这组数字就会发现关键破绽。Artificial Analysis公布的高时延优势排除了首字延迟(TTFT)与系统通信开销,仅仅衡量了生成速率。一旦进入第三方机构的受控真实闭环,光鲜的跑分立刻出现了严重的断层。
在Vals AI的实测中,官方号称成功率达90.6%的Terminal-Bench 2.1,复测成绩骤降至74.53%;而在更复杂的Terminal-Bench 4.0场景下,独立实测成功率更是暴跌至19.70%,不及官方42.3分宣传水准的一半。
这种跑分倒挂表明,模型在经过特定场景提示词微调后,能在静态单次测试中刷出漂亮指标;但只要放进真实的命令行操作与长流程工具调用环境,因果编解码器在多步状态管理上的脆弱性就会被无限放大。
百万上下文的执行幻觉与隐形账单
眼下OpenRouter上流向V4.1 Flash 1017的流量,绝大部分来自高频的AI编程智能体:omp吃掉了1.38亿Token,Cline占用了1.01亿Token,Nous Research的Hermes Agent和Kilo Code也分别输送了超过8500万Token。开发者之所以趋之若鹜,是因为它标榜同时具备1.0M上下文能力和极其诱人的缓存折扣。
然而工程一线的真实反馈却敲响了警钟。
虽然在vLLM单机8卡环境下,社区成功复现了950K上下文的双针特征检索,但在多机部署或复杂工业场景中,长文本的有效性迅速脱轨。在三台DGX-Spark集群部署的实测里,一旦多模态与长指令任务推至500K tokens以上,模型频繁出现任务流程顺利走完、但最终校验结果完全错误的执行幻觉。
在Reddit与Hacker News的开发者讨论区中,多位将V4.1 Flash接入实际代码库的工程师反映了长会话遗忘问题:随着上下文步步推进,模型极易丢失初期设定的工程约束与架构规范。更致命的在于经济账本的失控。当输入上下文突破特定阈值(约60%窗口)后,模型的KV缓存偶发重用失效。缓存未命中意味着计费将瞬间跳回0.15美元/M的全量计费区间,开发者本以为靠低单价占了便宜,最终却被因模型遗忘导致的反复Debug和重试掏空了预算。
| 评估维度 | 官方宣称 / 理想指标 | 独立第三方 / 生产实测表现 | 核心影响与落差诱因 |
|---|---|---|---|
| 上下文承载极限 | 标称 1.0M Context (950K 跑通) | 500K 以上执行完成但校验失败 | 长程推理退化与浮点精度损失 |
| 终端执行能力 | Terminal-Bench 4.0 官方 42.3 | 独立实测仅 19.70% 通过率 | 多步复杂状态管理容错率较低 |
| 实际调用成本 | 缓存命中下有效输入 $0.013/M | 阈值突破后缓存穿透账单激增 | 会话过长诱发重试成本反扑 |
- 提醒.1M上下文通跑并不等于具备1M可靠推理能力;高频重试的Agent应用如果盲目替换旗舰模型,端到端实际消耗反而可能激增。
DeepSeek V4.1 Flash 1017无疑交出了一份惊艳的工程答卷,它证明了因果编解码与极端不对称MoE能在显存控制和推理成本上走得多远。但对于正在构建生产级应用的团队而言,绝不能被纸面上的高速低价蒙蔽双眼。在超长会话的精度坍塌得到彻底修正前,它更适合充当单次任务的低成本执行者,而不是托付全部系统逻辑的总指挥。