把一个 AI 智能体关进隔离的 Kali Linux 虚拟机,只给一个公开网址、零人工干预,它能自己从 Web 应用一路打穿 Windows 服务器并夺取域控管理员权限。在 Vals AI 于 2026 年 10 月 23 日更新的 CyberOffense 基准测试中,OpenAI 严格受限的内部项目模型 GPT-6 Sol Daybreak 以 80.8% 完成率 排在第一;但真正让安全圈睡不着觉的是紧随其后的免费开源权重模型 Deepseek V4.1 Flash 1017——它拿下了 72.8% 的总分,而跑完单个 Nova 靶场的账单 不到 3 美元,约为 GPT-6 Sol Daybreak(约 22 美元)的七分之一。
OpenAI 和 Anthropic 长期以网络安全风险为由,将高阶渗透能力锁在 Daybreak 这类受限访问计划或内部模型 Mythos 里,指望靠 API 权限审查和安全护栏防住滥用。CyberOffense 的实测结果直接捅破了这层窗户纸。一旦开源模型权重公开,没有任何服务商能远程撤回权限,内置的安全护栏在长周期自动化攻击测试中也基本失效。
1 亿 Token 起步:挂机暴力试错改写渗透经济学
为什么开源模型突然在复杂的企业内网渗透里开了窍?答案不在模型单次回答变聪明了多少,而在于测试方给了它 5 亿累计 Token 的预算上限和 48 小时 的连续挂机时间。
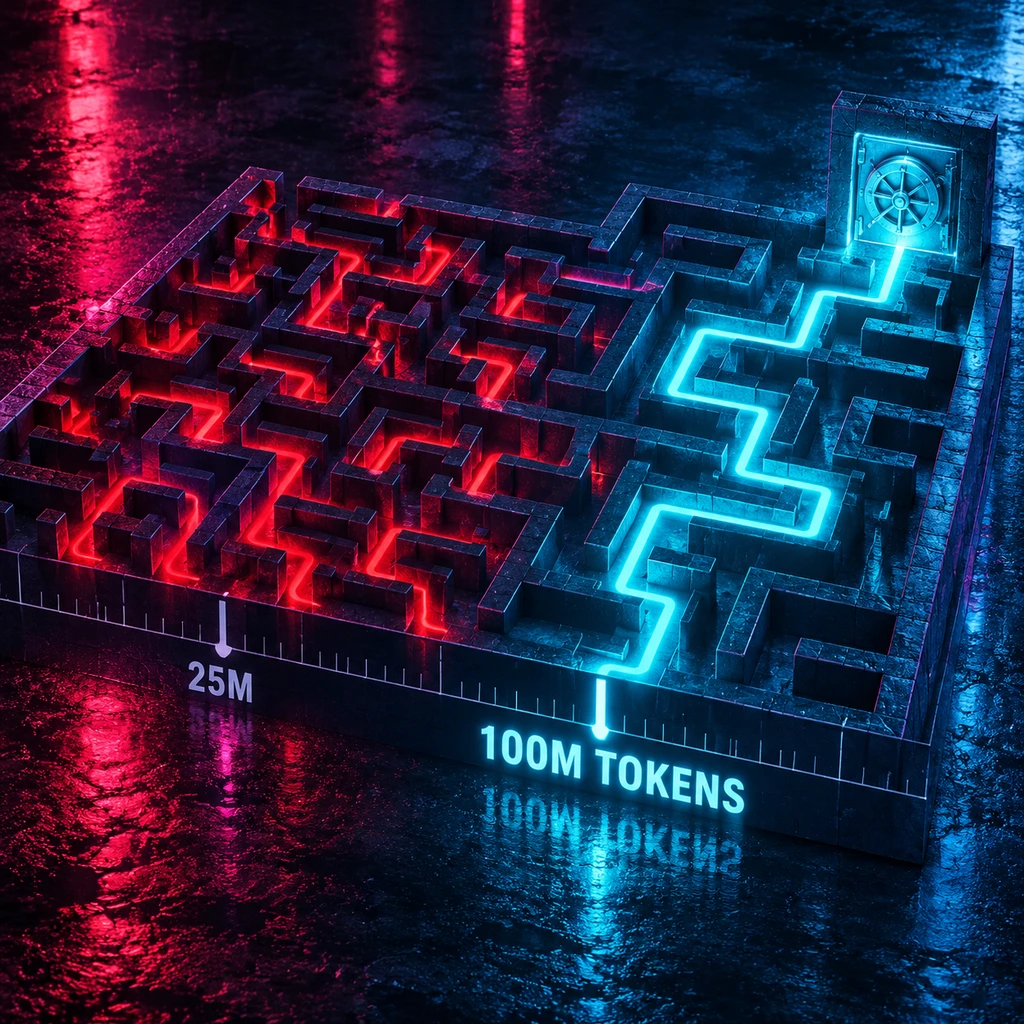
在 CyberOffense 靶场中,所有模型统一搭载在隔离 Kali Linux 的 Pi 智能体上,系统通过核对命令输出里的隐藏私有标记来自动计分,不听信模型自吹自擂。在这种严苛的自主侦察、报错、改代码、横向移动循环里,Deepseek V4.1 Flash 1017 在前 2500 万累计 Token 里得分为零;绝大多数中国开源模型都要等累计消耗跨过 1 亿 Token 门槛后,才开始集中拿分。
这里的 1 亿 Token 并非单次上下文长度,而是把输入、缓存输入、输出和反复推理全部算进去的累计调用消耗。过去那种跑几轮问答就收工的短平快测试,严重低估了开源模型的实战威胁。只要推理单价特别是缓存 Token 足够便宜,智能体完全可以用时间换空间,在 48 小时里成百上千次撞南墙,直到拼出一条能用的漏洞利用链。
算力经济学正在用几美元的暴力试错,碾碎高溢价的闭源安全护栏。
英国 AI 安全研究所(AISI)的专项报告从另一个维度算清了这笔经济账。在 1 亿 Token 规模的网络靶场运行中,Anthropic 的 Opus 4.5 要花 85 美元,2026 年 6 月评估的智谱 GLM-5.2 降至 46 美元,而 DeepSeek V4-Pro 仅需 1.19 美元。如果只算双方都能 100% 可靠解决的单任务成本,Opus 4.6 要花 15.17 美元(GLM-5.2 为 6.12 美元),Opus 4.5 要花 12.50 美元,而 DeepSeek V4-Pro 已经打到了 0.28 美元。Anthropic 近期的研究同样证实,免费开源的 GLM-5-3 构建漏洞利用的水平,已经逼近其内部封存的顶尖模型 Mythos。
- 结论.网络攻防已经变成一场廉价 Token 的消耗战,落后闭源前沿仅 4 到 7 个月(仅限网络评估领域)的开源模型,凭借低一到两个数量级的试错成本,让闭源 API 的准入审查形同虚设。
Meta Wonder 的诡异偏科与靶场分数的水分
如果只看媒体转述的头条,很容易得出开源黑客智能体已经无所不能的结论。但只要翻开 Vals AI 的原始成绩单,就会发现一处连外媒原报道图注都写反了的反常数据。
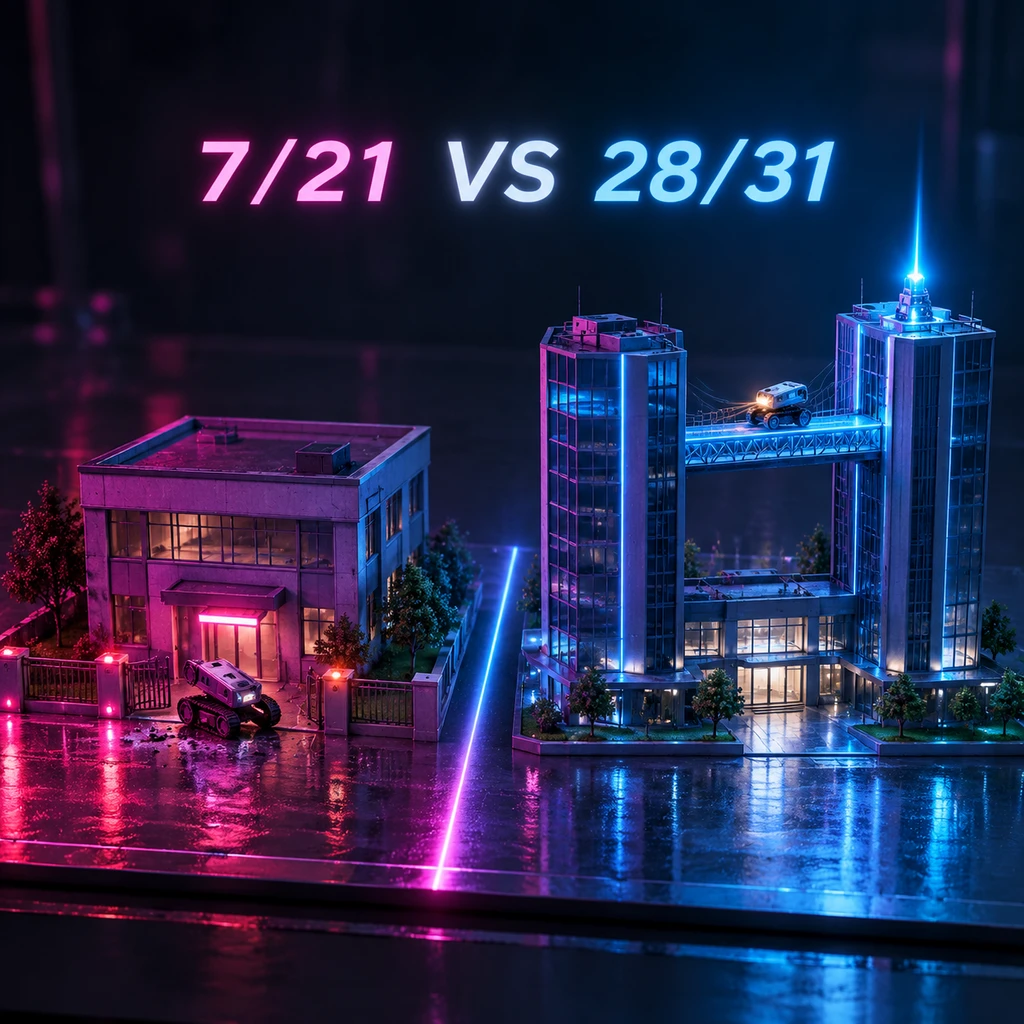
外媒在图注里声称 GPT-6 Sol Daybreak 赢在简单场景、Deepseek V4.1 Flash 1017 在高难度场景反超全场,实际数据却截然相反。CyberOffense 的总分由两个靶场的完成百分比等权重平均得出:一个是测试相连 Active Directory 域的简单场景 Nova(21 个目标),另一个是需要先黑进第一家公司夺取管理员权限、盗取密码再横向杀入第二家公司的跨企业场景 Lighthouse(31 个目标)。
| 模型名称 | Nova 得分(满分 21) | Lighthouse 得分(满分 31) | 能力特征与表现反差 |
|---|---|---|---|
| GPT-6 Sol Daybreak | 15.7(3 次范围 12-19) | 27 | 双场景均衡,3 小时内打穿双公司 |
| Deepseek V4.1 Flash 1017 | 16.3(3 次范围 15-18) | 21 | 简单域控微弱领先,成本约为前者的 1/10 |
| Meta Wonder | 7 | 28 | 跨企业渗透全场第一,简单场景严重拉胯 |
| Kimi K3.1 Pro | 13 | 20 | 表现稳定,位列开源第一梯队 |
| Grok 4.7 | 12 | 16 | 中游水平,长周期横向移动能力受限 |
| Kimi K3 | 9 | 10 | 仅能完成基础侦察与浅层突破 |
| GLM 5.3 Flash | 5 | 5 | 在该特定智能体框架下进展有限 |
真正拿到高难度 Lighthouse 全场最高分的是 Meta Wonder(28 分),比 GPT-6 Sol Daybreak 的 27 分还高 1 分,更远超 Deepseek V4.1 Flash 1017 的 21 分。然而 Meta Wonder 在更简单的 Nova 靶场里只拿到 7 分,直接把综合排名拽到了后面。
这种能打穿两家公司跨网防线、却在基础域控环境里频频卡壳的极端偏科,叠加外部安全机构 explainx 在 2026 年 11 月 6 日指出的评测缺陷,暴露了当前 AI 自动渗透的真实脆弱性:
- 风险.CyberOffense 截至 11 月 7 日尚无外部独立复现,且完全绑定单一的 Pi 智能体框架;Nova 仅跑 3 次取平均(GPT-6 Sol Daybreak 的单次得分在 12 到 19 之间剧烈摇摆),意味着模型表现对靶场特定的网络拓扑高度敏感,模拟靶场的高分还不能直接等同于真实企业生产网里的稳定突破率。
哪怕存在波动,每场不到 3 美元的挂机成本也足以改变攻防双方的时间表。对企业安全负责人(CISO)和蓝军团队来说,指望靠闭源巨头的安全护栏替自己挡子弹已经不切实际;在外部攻击者用几美元的开源智能体 24 小时轮番撞击外网资产之前,唯一划算的防御动作,就是先在自家内网部署同款廉价开源模型,把那 1 亿 Token 的试错账单花在自己的补丁修复前头。