大模型竞争演化到今天,最隐秘的战场早已不是前台的参数与跑分,而是机柜深处谁在为每一行底层算子买单。
DeepSeek与华为联合开源了一套针对昇腾AI芯片的底层编程工具库,核心是源自北京大学团队研发的 TileLang 编程语言。双方还针对由 128颗昇腾950芯片 构成的 SuperNode 超级节点集群进行了协同优化,涵盖密集计算算子以及跨芯片数据搬运。DeepSeek 同步开源的 DeepGEMM-Ascend 代码库,也正是在昇腾950硬件上完成了工程验证。
消息一出,行业里惯常的欢呼再次涌现,不少人甚至将其直接冠以“打破英伟达 CUDA 铁幕”的里程碑。但把工程底牌摊开来看,这更像是一场极其务实、刀口向下的垂直突围,而不是通用生态的全面平替。
算子手艺人的解放
要看懂 TileLang 为什么重要,必须先理解此前在昇腾架构上写算子的痛苦。
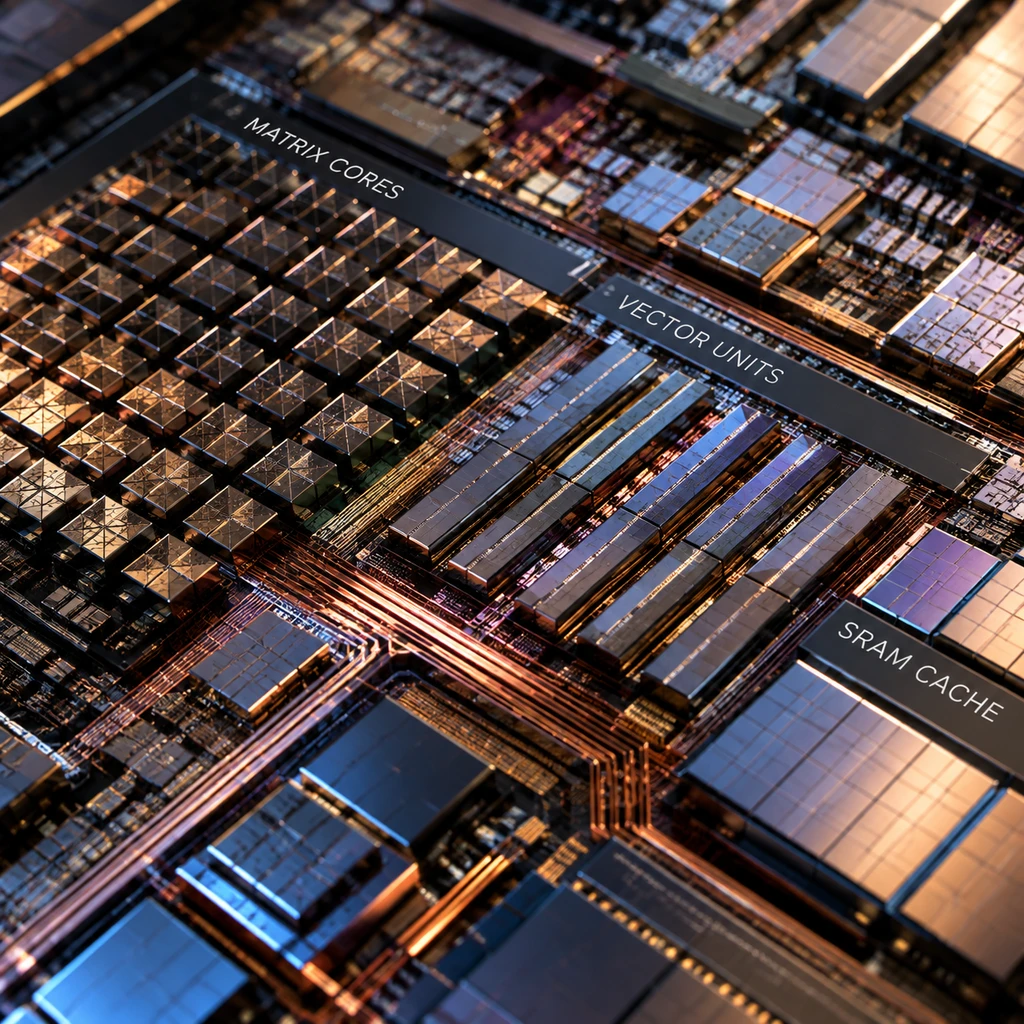
在主流深度学习体系中,英伟达的 CUDA 凭借二十年的沉淀,把矩阵乘法、注意力机制等算子包装得极尽平滑。开发者即便不碰底层汇编,也能靠成熟的 cuBLAS 或 Triton 拿到很高的算力利用率。而昇腾原生的底层开发工具是 Ascend C,其编程心智更接近面向硬件寄存器与片上缓冲区的精准操舵。开发者不仅要手动管理数据在片外与片内多层内存间的切分与搬移,还要极其小心地协调 Cube 计算单元与 Vector 矢量单元的流水线同步。
把顶级算法工程师逼成手写汇编的手艺人,是硬件生态发展初期最昂贵的内耗。
TileLang 的解题思路,是借用类似 Pythonic 的瓦片(Tile-level)抽象,将细碎的数据布局与搬迁逻辑封装在上层,交由编译器自动生成后端代码。在昇腾早期硬件测试中,它展现出令人惊艳的编译效率:GEMM 矩阵乘法性能达到手写原生 Ascend C 的 0.98x,DeepSeek-V4 mHC 向量算子约为 0.96x,而结构更为复杂的 Flash Attention 也达到了 0.95x。
换言之,TileLang 首先解决的是算子开发效率危机:它让国内稀缺的高水平算法工程师,不必再把大量精力耗费在晦涩的硬件底层对齐上。
单算子达标不等于系统级平替
然而,单算子能效逼近手写极限,绝不意味着整个大模型训练与推理系统已经能与英伟达分庭抗礼。
芯片工业里有一句老话:“算力是标称出来的,带宽是花钱买来的,吞吐是系统磨出来的。”华为对外披露其 64 个 Atlas 950 SuperPoD 集群合计标称峰值算力可达 524 EFLOPS (FP8) 与 1 ZFLOPS (FP4),但这属于理论上限。在真正支撑万亿 MoE 模型全并发调度时,系统瓶颈往往会从单卡计算迅速转移到跨节点通信拓扑与内存编排。
以当下主流架构为例,DeepSeek 引以为傲的多头潜在注意力(MLA)与稀疏 Expert 动态路由,极度依赖高并发小数据包的跨节点吞吐。英伟达依托 NVLink 与 NVSwitch 编织的通信网,配合 NCCL 库,形成了难以逾越的系统墙。而昇腾的 HCCS 互联体系在单节点 128 卡 SuperNode 内能够实现高密度整合,但在多节点超大规模集群的真实工况下,端到端实际利用率依然缺乏严谨的第三方透明对比。
TileLang 是个优秀的编译器前端,但它无法替底层硬件改变物理互联延迟与跨节点通信损耗。这也是为何业内对这套方案更倾向于定义为“特定模型架构下的深度定制”,而非通用计算的标准解法。
英伟达护城河究竟在防什么
讨论这起开源事件,必须厘清 CUDA 护城河正在发生的变化。
市场研究机构 SemiAnalysis 在测试 OpenAI 的自研推理芯片 Jalapeño 时曾给出一个论断:在纯粹的推理场景下,CUDA 护城河已经“潜在死亡”。OpenAI 能够快速把前沿模型迁移到自研硬件上,且 Jalapeño 在 8,000 输入与 1,000 输出 tokens 的常规测试中,每瓦性能甚至超过了英伟达 Blackwell。这证明只要模型结构相对固定、软件栈高度垂直,绕过 CUDA 并非天方夜谭。
但问题的转折点在于更复杂的动态场景。在评估多步骤复杂智能体调度的 AgentX 基准测试中,英伟达仍然大幅领先。面对 AMD 旗下的 MI355X,即使其在 MLPerf 6.0 中纸面规格直逼 B200,但只要进入包含动态推理、长上下文检索和多智能体协同的深水区,ROCm 算子覆盖参差与调度开销就会让整体性价比迅速恶化。
英伟达的真正防线早已不在单卡矩阵乘法上,而在数百万开发者基于庞大工具链沉淀下来的排障经验与系统级容错。华为官方披露拥有超过 3,000 家昇腾伙伴和约 400 万开发者,而英伟达公布的全球 CUDA 开发者基数也已超过 400 万(CEO 信中口径甚至突破 600 万)。但二者的统计口径并不等同:CUDA 开发者是以开源社区、通用框架为阵地自发形成的长尾网络,而昇腾目前的生态力量更多集中在大客户与专项适配之中。
- 结论.对于具备顶级工程重构能力的团队,用定制 DSL + 本土芯片打通专有模型推理是完全成立的技术路线。
- 风险.普通企业若无 DeepSeek 级的系统调试能力,直接迁移到非 CUDA 体系仍将承担极高的长尾适配成本与工程排错代价。
正如《孙子兵法》所言:“兵无常势,水无常形。”面对外部持续收紧的出口管制,华为轮值董事长徐直军直言不能把未来押在外部断供风险上。DeepSeek 与华为的联手,实质上是用类似苹果式的“垂直软硬闭环”策略,在英伟达横向垄断的通用版图上硬生生凿出一个切口。
这不是一场一蹴而就的生态革命,而是一次极为艰难的战壕争夺。接下来真正决定这套方案成色的,不是开源代码仓库里收获了多少个 Star,而是昇腾 950 SuperNode 集群在真实复杂工况下的端到端吞吐,以及外部第三方团队复现这套技术栈时所付出的真实工程代价。