2026 年 11 月 4 日,OpenAI 宣布网络安全专用准入项目 Daybreak Red 通过 Amazon Bedrock 上线 AWS GovCloud 美东区域(us-gov-east-1),向获批的美国政府及关键任务团队开放专用模型 GPT-5.6 Cyber。这款支持 272K 上下文窗口的模型,在 AWS 商业区每百万 Token 输出定价高达 82.50 美元,政务云专属账单费率与吞吐配额尚未公开。对比早已晒出联邦高敏工作负载批文的 Anthropic,OpenAI 此番借道主权云,兜售的并非全方位的网安推理碾压,而是高溢价的合法拆护栏特权。
对于手握未公开漏洞的国家级防御团队而言,这次上线真正解开的是数据主权死结。漏洞挖掘与黑客开发攻击载荷在底层代码推理上高度同源,通用大模型为防滥用普遍加装严密拦截器,导致白帽研究员上传真实漏洞脚本时频频遭遇误伤拒答;而政府与军工部门又绝无可能把零日漏洞或核心系统源码直接发往 OpenAI 自有平台。Amazon Bedrock 在此充当了数据隔离舱,承诺推理数据不用于模型训练,客户也无需向 OpenAI 共享业务数据。
95% 响应率背后的能力真相,卖的是白名单豁免
OpenAI 把 GPT-5.6 Cyber 包装成专为网络安全训练的前沿模型,但翻开其 2026 年 8 月 10 日披露的基准底表,最悬殊的差距出在拒答率而非硬核攻防智商。在这项名为高级网络安全完成率的测试中,GPT-5.6 Cyber 拿下了 95.0% 的高分,而上一代 GPT-5.5 Cyber 为 57.3%,挂载初级权限 Daybreak Blue 的通用模型 GPT-5.6 Sol 跌至 2.0%,标准版 GPT-5.6 Sol 更是只有 1.5%。
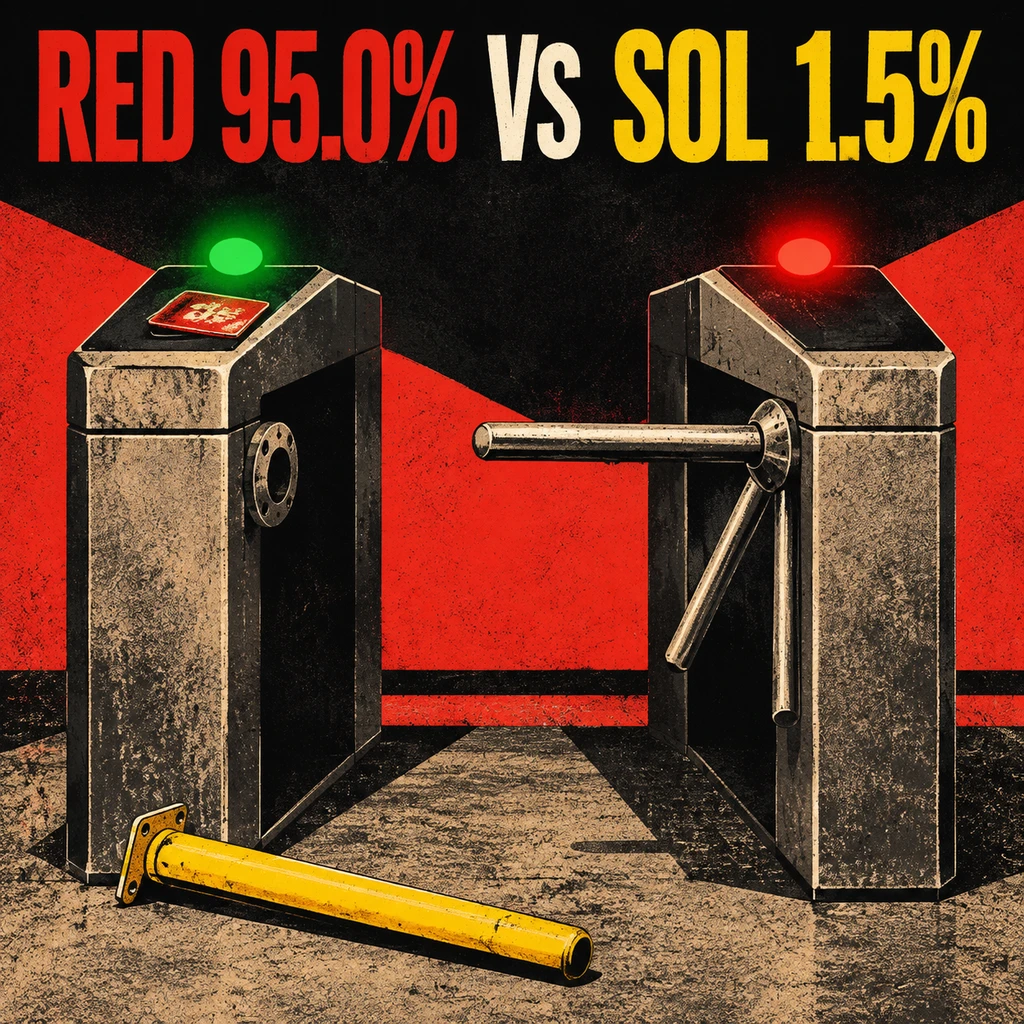
这个 95.0% 仅代表模型愿意接单干活、不触发安全拒答的比例,并不等同于漏洞利用成功率。在更考验耐力的标准 300 轮 ExploitBench 长程测试及漏洞报告撰写任务中,专用版 GPT-5.6 Cyber 的实测表现反而不如通用版 GPT-5.6 Sol,它只在 ExploitGym 和内部零日评估里占优。至于安全研究机构 Irregular 在 2026 年 6 月 26 日发布的联合评测,测试对象其实是通用版 GPT-5.6 Sol,目前外界没有任何针对 GPT-5.6 Cyber 的独立第三方跑分。
买下天价门票的防御团队,到手先是一张免拒答白名单。
落到实战工作流里,政府安全工程师很难靠这一款模型包打天下。团队在复现高敏漏洞脚本时必须调用不拒答的 GPT-5.6 Cyber,但到了上百轮自动化推理或撰写修复报告阶段,往往还得切回长程能力更稳的通用模型打配合。
百万输出 82.50 美元与三重门禁,下游安全厂商无缘分羹
想在政务云里调通这个模型ID为 openai.gpt-5.6-cyber 的接口,采购方必须跨过繁琐的行政与预算门槛。该模型早在 2026 年 8 月 11 日就已首次登陆 Amazon Bedrock 商业区,目前仅开放俄亥俄商业区(us-east-2)与美东政务云两个节点。参考 AWS 模型卡披露的商业区 Standard 层定价(已含商业区 10% 附加费),其算力账单远超常规前沿模型。
| 计费与规格项 | AWS 商业区 Standard 层标准 | 预算与工程影响 |
|---|---|---|
| 输入单价 | 13.75 美元 / 百万 Token | 大体量源码投喂成本高企 |
| 缓存写入 / 读取 | 17.1875 / 1.375 美元 / 百万 Token | 重复审计同库代码依赖缓存降本 |
| 输出单价 | 82.50 美元 / 百万 Token | 多轮漏洞验证 Agent 极易烧穿预算 |
| 上下文窗口 | 272K Tokens | GovCloud 专属溢价与配额仍未透明 |
比账单更严苛的是准入锁死。OpenAI 不向常规个人开放 Daybreak Red(个人通常只能申请权限受限的 Blue 档),企业拿到 Red 资格后,调用 GPT-5.6 Cyber 还得再过一道模型级审批,最后再找 AWS 账户团队人工配置权限。OpenAI 条款明确将该权限锁死在机构内部授权安全工作,托管安全服务商(MSSP)和商业网安公司无法直接调用该接口打包成 SaaS 卖给下游政企客户,除非另签商业协议。
首批尝鲜的政府工程师还会撞上文档错位的工程摩擦。AWS 其实早在 2026 年 10 月 30 日就抢先发出了上线公告,比 OpenAI 官宣早了整整 5 天;可在 AWS 官方模型卡的区域列表里,至今仍只挂着俄亥俄商业区和 bedrock-mantle 端点,与区域参考表里列出的 us-gov-east-1 及 bedrock-runtime 端点自相矛盾。
- 提醒.OpenAI 帮助文档明确注明 Daybreak 资格审批默认不包含零数据留存(ZDR),政企法务在签单前仍需与 AWS 及 OpenAI 单独敲定底层日志留存边界。
进驻 GovCloud 不等于合规通关,联邦身位仍落后 Anthropic
单看官方通稿,外界极易误以为 GPT-5.6 Cyber 已经拿到了美国联邦机构的合规通行证。但 AWS GovCloud 官方文档写得很直白,某款模型在政务云区域可用,绝不自动代表该模型部署已取得 FedRAMP 合规覆盖,采购机构必须逐一核查 AWS 独立的模型认证矩阵并自行完成系统运行授权(ATO)。截至目前,无论是 OpenAI 还是 AWS 的公告,均未确认 GPT-5.6 Cyber 拿下了具体的 FedRAMP High 或美国国防部 DoD IL4/IL5 级别认证。
放到国家级网安预算的争夺战里看,OpenAI 目前正处于追赶身位。竞争对手 Anthropic 不仅运营着同类的网络安全验证计划(覆盖 Opus 5.5、Sonnet 5.5 与 Mythos 5.1 模型,同样实行实名准入与降低拦截触发),更早在 2026 年 9 月 30 日就正式推出了运行于 FedRAMP High 授权环境的 Claude for Government,其 Bedrock 上的部分模型已获批承载 GovCloud 内的 FedRAMP High 及国防部 DoD IL4/IL5 高敏工作负载。