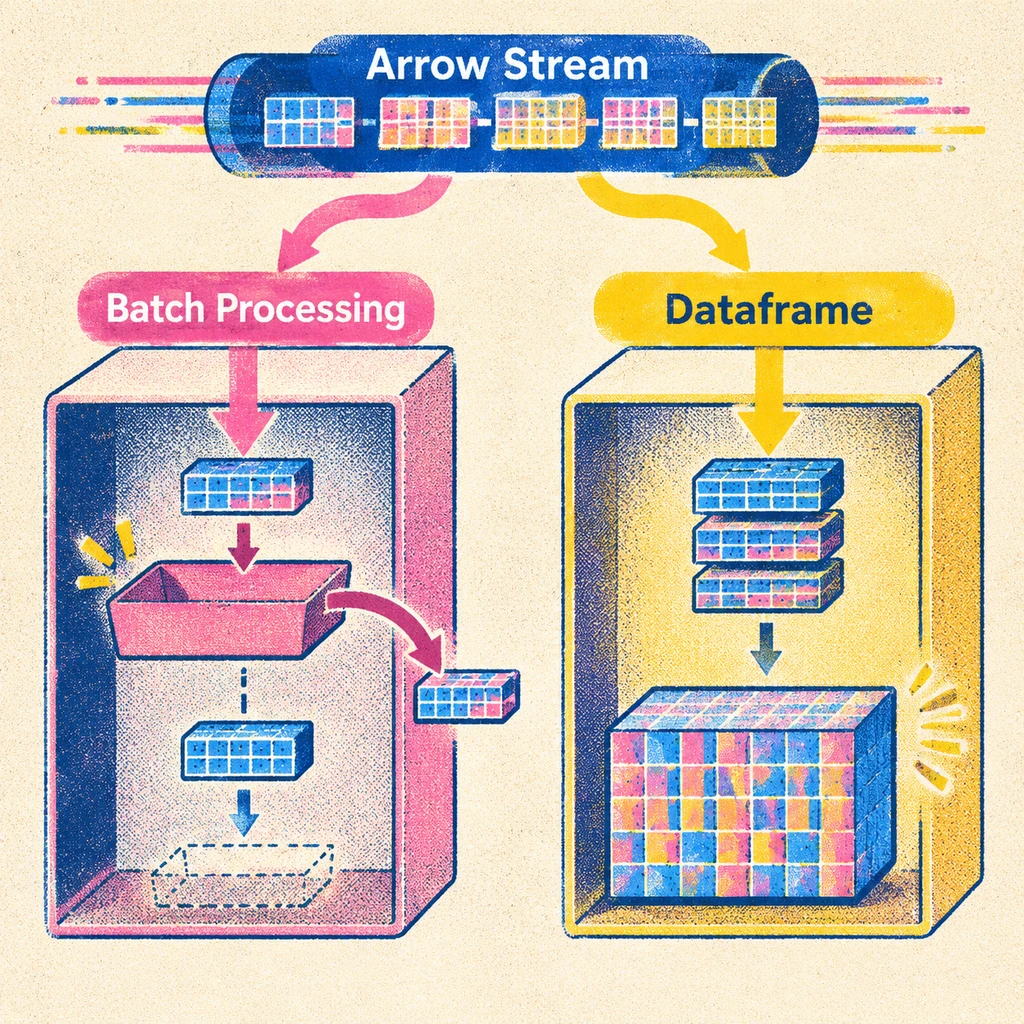
11 月18 日,Datasette 插件 datasette-arrows 发布首个预览版0.1a0,为表、视图和 SQL 查询结果增加 Apache Arrow IPC 流式导出。和内置的 CSV、TSV 一样,Arrow 可以分批发送数据;它还把列类型一并传给 DuckDB、pandas 和 Polars 等分析工具,省去文本解析和类型推断。代价是,导出过程中每一批数据都得符合开头定下的列类型,否则下载可能中途失败。
Datasette 已能全量导出,界面还没跟上Datasette1.0a43 开放了插件的流式输出接口,插件可以分批接收 SQLite 查询结果,边转换边发送。安装 datasette-arrows需要 Datasette1.0a43 或更新版本,以及 Python3.11 或更新版本。
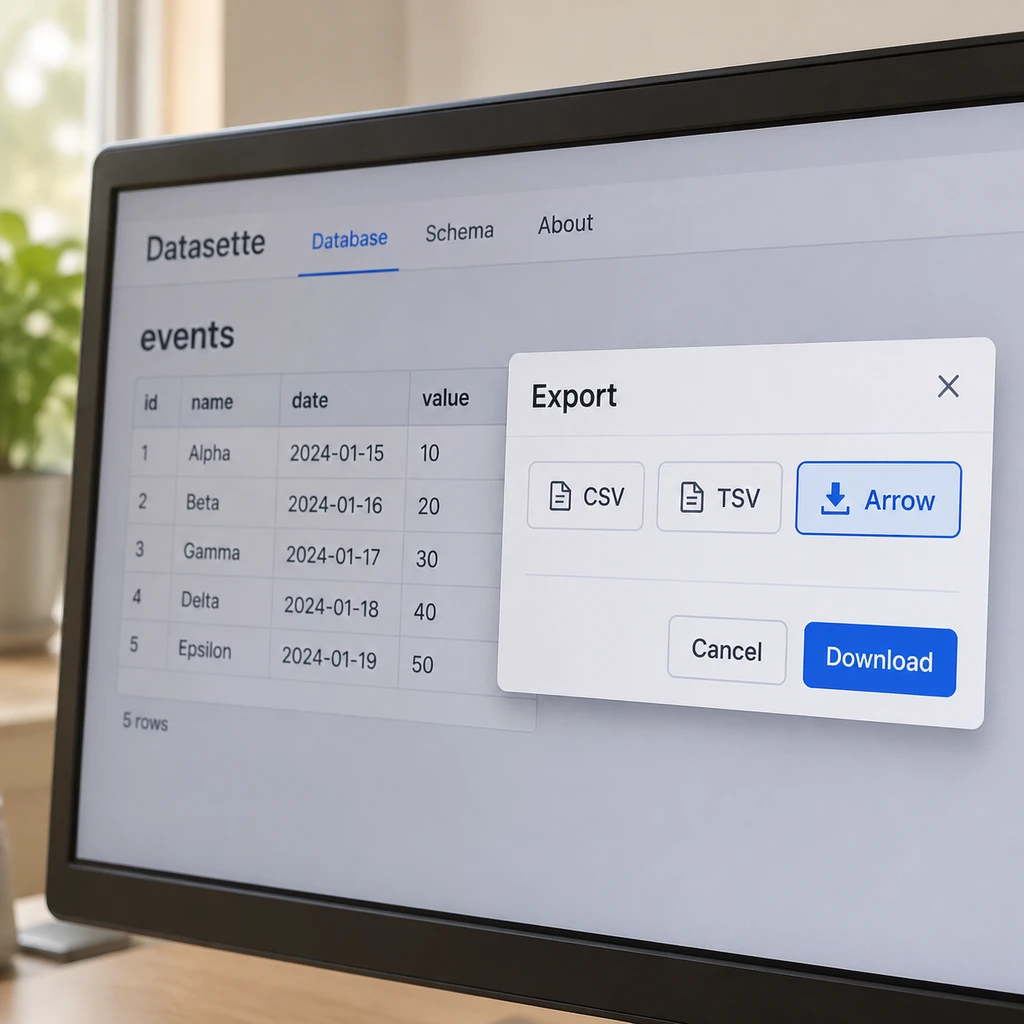
表或视图的 .arrows 地址默认只导出当前页。要拿到全部匹配行,需加上 ?_stream=1;再加 &_dl=1,可触发文件下载。作者展示的全表导出界面来自开发主分支,已发布的 alpha里,全表导出区域要等下一次 alpha 才计划加入 Arrow。维护者现在就能提供全量导出链接,但需要把参数配好。
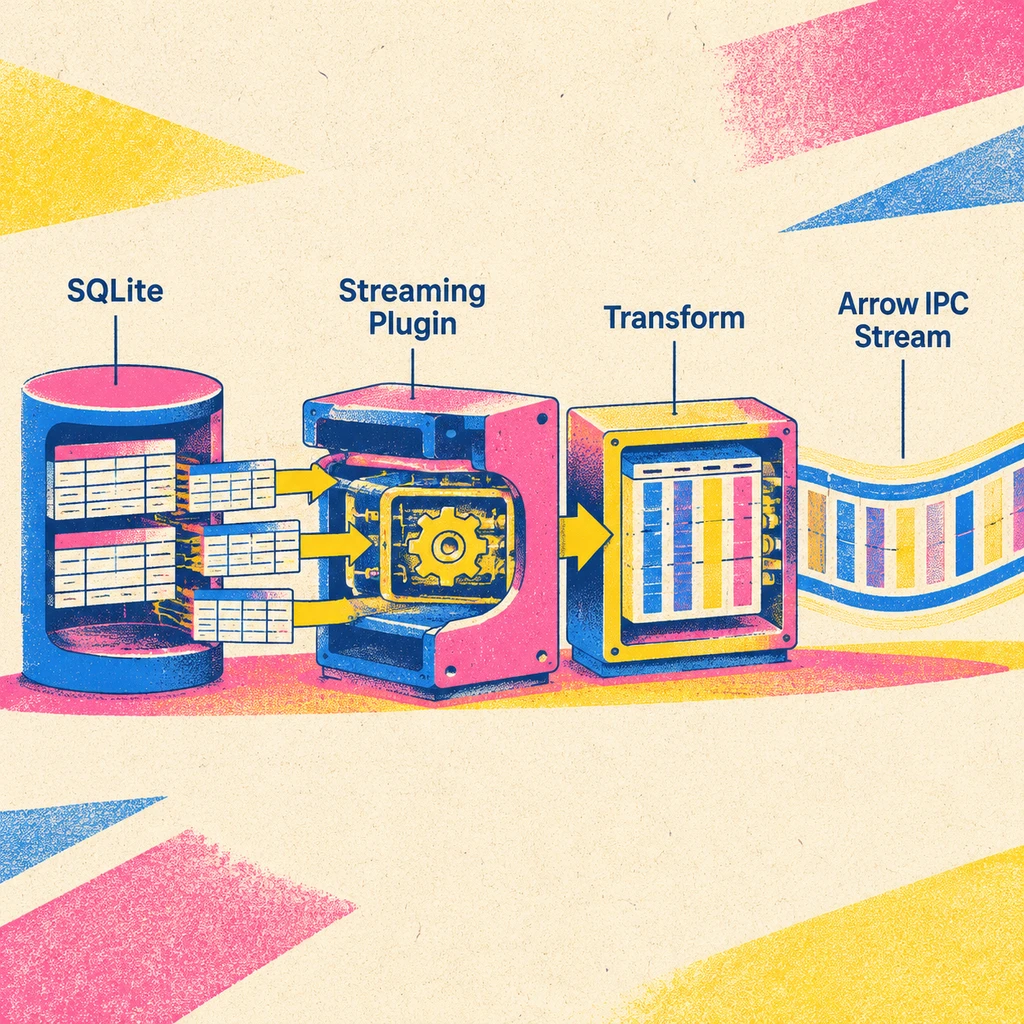
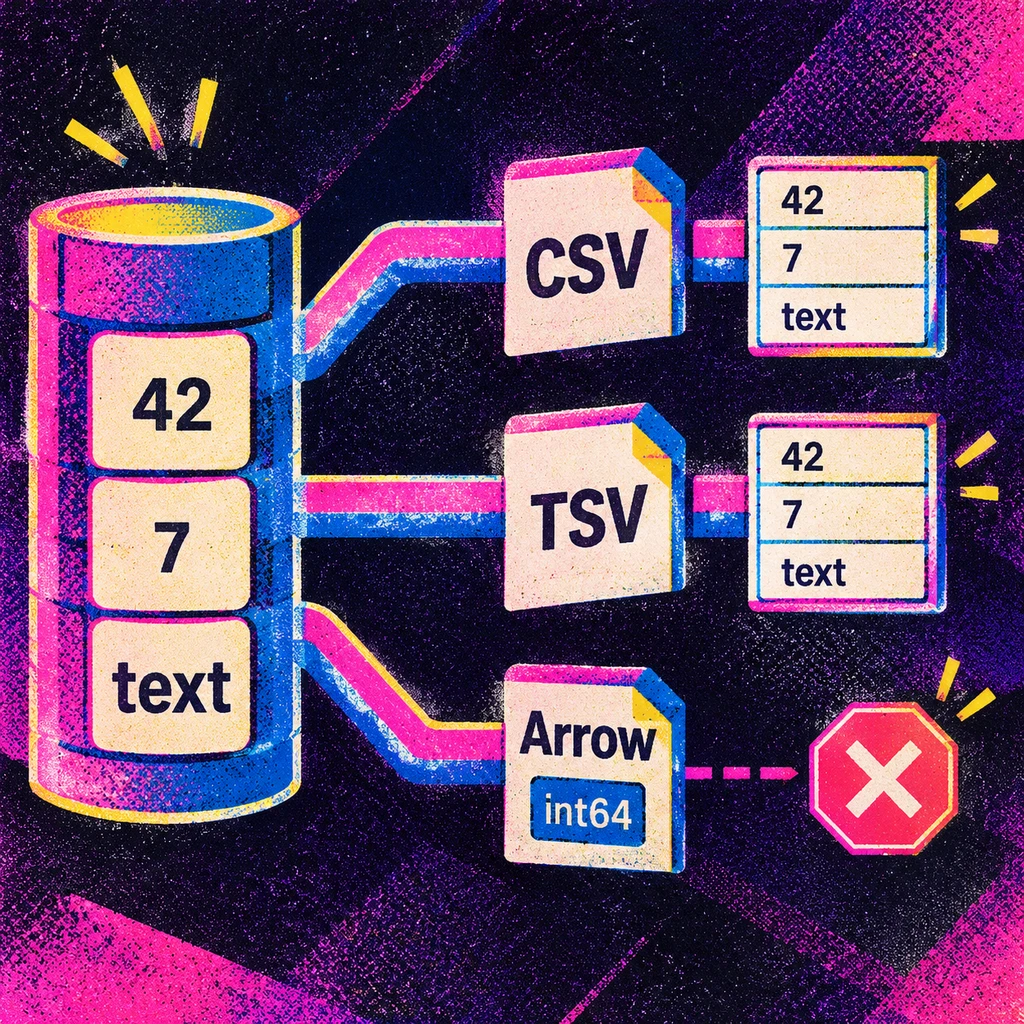
首批数据定下列模式,后续批次必须沿用插件根据 SQLite 的声明类型和首批数据确定 Arrow 的列模式,此后每读到一个非空页面,就把它转成一个 Arrow记录批次并写入流。SQLite允许同一列出现不同类型的值,Arrow IPC 流则要求各批次共用一套列模式。如果后续值无法按既定类型写入,连接就会中断,已经发出一部分数据的下载也会失败。
<svg viewBox='00660210' width='100%' height='210' role='img' aria-label='Arrow 流式导出的列模式由声明类型和首批数据确定,后续批次沿用,无法适配时下载中断'>
<rect x='0.5' y='0.5' width='659' height='209' rx='14' fill='#fbf9f4' stroke='#e2dccf'/>
<text x='28' y='38' font-size='19' font-weight='700' fill='#b25a3a'>首批定模式,后续沿用</text>
<line x1='28' y1='54' x2='632' y2='54' stroke='#e2dccf'/>
<rect x='28' y='82' width='172' height='86' rx='9' fill='#fbf9f4' stroke='#e2dccf'/>
<rect x='244' y='82' width='172' height='86' rx='9' fill='#fbf9f4' stroke='#b25a3a'/>
<rect x='460' y='82' width='172' height='86' rx='9' fill='#fbf9f4' stroke='#e2dccf'/>
<line x1='210' y1='125' x2='230' y2='125' stroke='#b25a3a'/>
<polygon points='230,121236,125230,129' fill='#b25a3a'/>
<line x1='426' y1='125' x2='446' y2='125' stroke='#b25a3a'/>
<polygon points='446,121452,125446,129' fill='#b25a3a'/>
<text x='114' y='118' text-anchor='middle' font-size='16' font-weight='700' fill='#2c2822'>声明类型与首批数据</text>
<text x='114' y='143' text-anchor='middle' font-size='13' fill='#7a7266'>共同决定列类型</text>
<text x='330' y='118' text-anchor='middle' font-size='16' font-weight='700' fill='#2c2822'>固定列模式</text>
<text x='330' y='143' text-anchor='middle' font-size='13' fill='#7a7266'>供各批次共用</text>
<text x='546' y='118' text-anchor='middle' font-size='16' font-weight='700' fill='#2c2822'>后续批次写入</text>
<text x='546' y='143' text-anchor='middle' font-size='13' fill='#c0392b'>类型不兼容则中断</text>
</svg>
CSV 和 TSV 会把值写成文本,同一列可以同时传出数字和文字,类型怎么解释留给接收端。Arrow 把这项决定提前到了服务端。维护者如果要给类型混杂的公开数据加上 Arrow 下载,将输出列统一成明确的类型,会比直接开放原表更稳妥。
服务端分批发送,客户端仍可能整份载入分析用户能省下多少内存,取决于客户端怎么读。逐批处理可以避免把全量结果同时放进内存;如果用 pandas 或 Polars 把整条流读成一个数据帧,客户端仍要容纳完整结果。
目前缺少公开的 CSV、TSV 对照基准。Arrow省去了客户端的文本解析,服务端仍要从 SQLite读行、转成列式批次再序列化。要判断定期全量导出是否值得换格式,得用同一份真实数据比较总耗时和两端峰值内存,并把逐批消费与整份载入分开测。