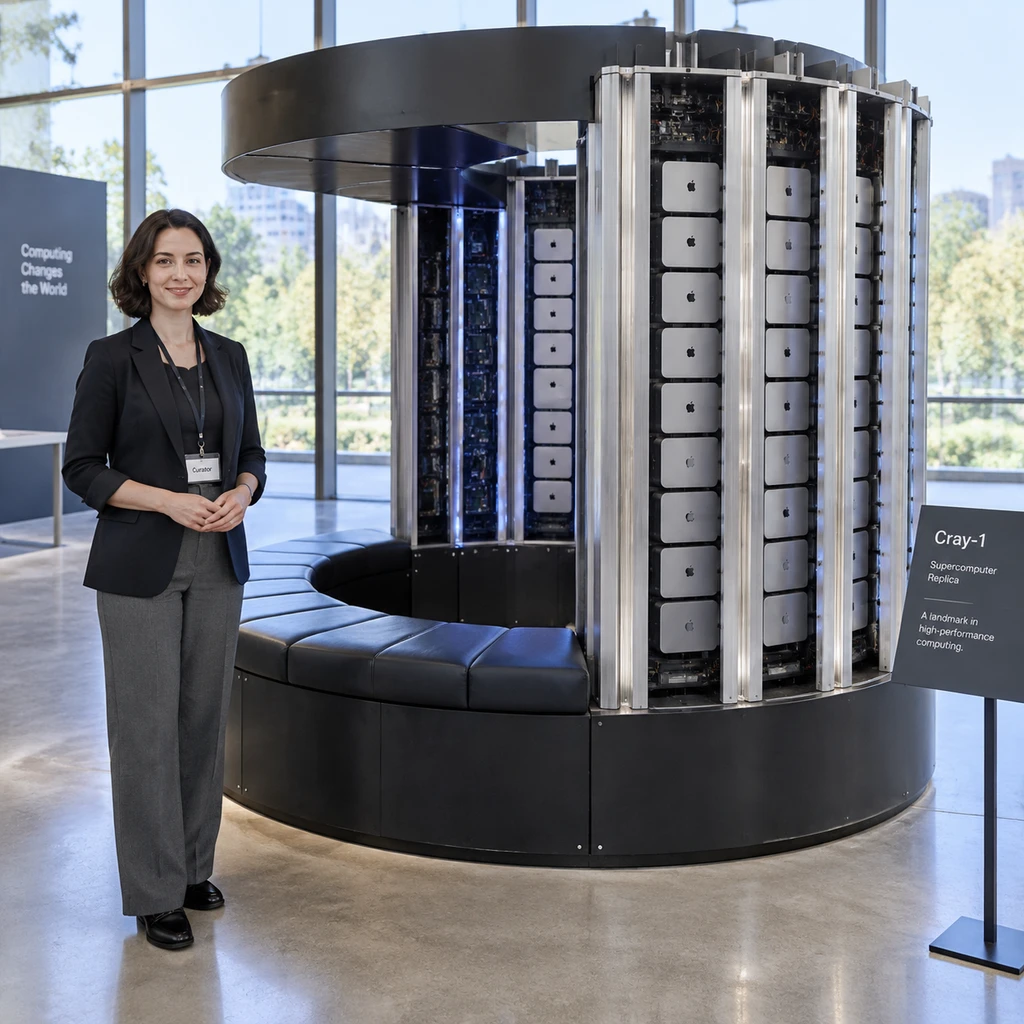
西班牙卡塞雷斯省的埃斯特雷马杜拉大区,一座计算机历史博物馆近日把 30 台已被市场淘汰的英特尔架构 Mac mini 塞进了一个巨大的 C 字形机柜。他们耗时 18 个月,按 1:1 比例完整重现了 1976 年传奇超级计算机 Cray-1 的外形,并测出了最高 1.5 TFLOPS 的浮点运算能力。
在摩尔定律狂奔半个世纪后,用被丢弃的消费电子展现近万倍于人类首台超级计算机的算力,确实制造了极强的传播反差。但这场狂欢更像是一次高明的极客装置艺术与科普策展,一旦撕开外壳,其松散的千兆网络连接与特挑的测试脚本,恰恰折射出当代算力系统最棘手的命门:堆叠核心从来不难,消灭互联延迟才是终极天花板。
30台报废硬件的算力重构:一场摩尔定律的视觉巡礼
2026 年 9 月 26 日,在西班牙 Majadas de Tiétar,计算机历史博物馆馆长 Carlos Izquierdo 正式揭幕了这台庞然大物。机身覆以黑色、白色以及象征埃斯特雷马杜拉大区的绿色涂装,标志性的马蹄形断环和下层软包长椅被原汁原味还原。内部驱动它的,是 28 台 2012 款与 2 台 2014 款 Mac mini。硬件阵容包括 25 台双核 Core i5 与 5 台四核 Core i7,物理核心共计 70 个。
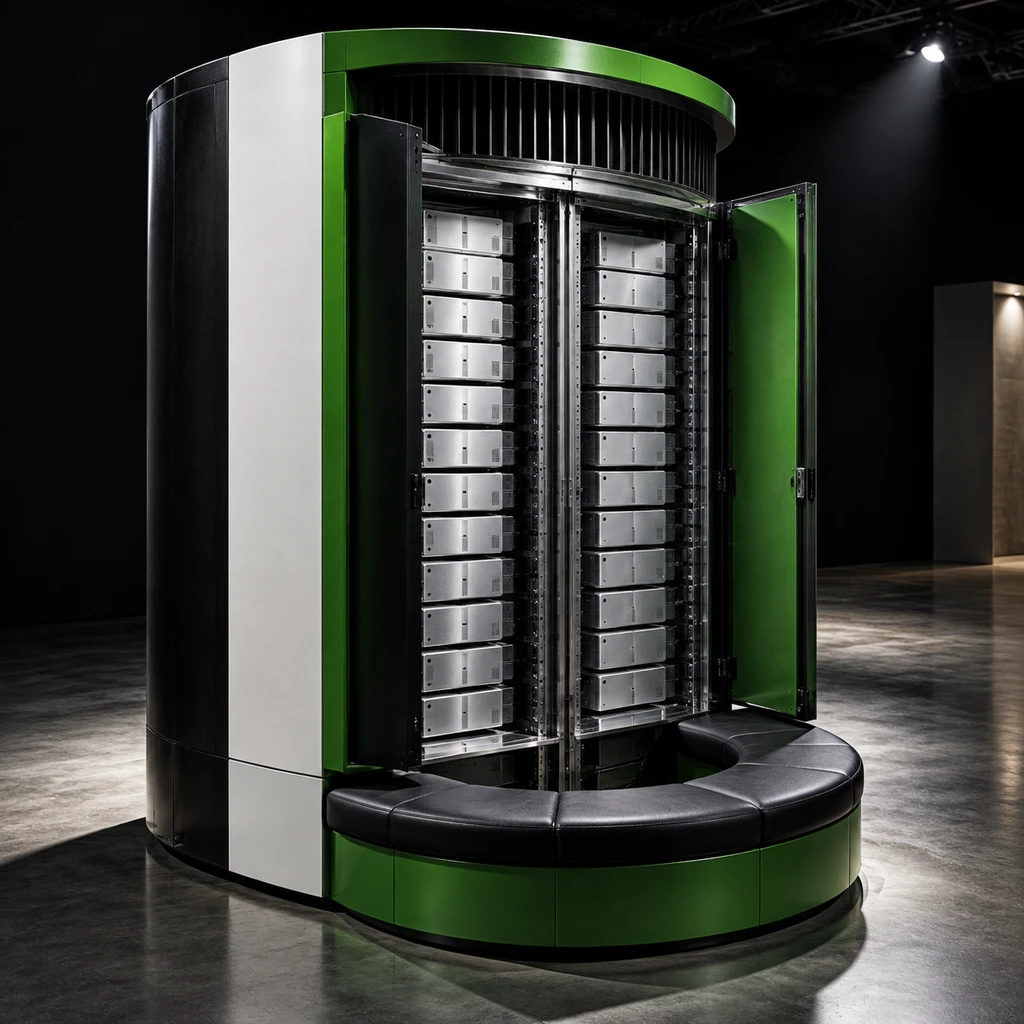
在工程实现上,博物馆团队避开了标准 Linux 方案,选择由 macOS Mojave 10.14 系统内置的 MPI 框架串联各节点。为了控制展厅噪音,整机未添加辅助机械风扇,而是依托垂直钢机架与铝制托盘,利用热空气上升原理构建出自然的烟囱风道散热。依照苹果官方规格,2012 款与 2014 款待机功耗分别为 11W 和 6W,CPU 满载峰值为 85W。据此推算,这套由 30 台主机组成的集群,待机基准功耗约 320W,满载约为 2550W。
西摩·克雷当年造出的原版机器峰值浮点算力仅为 160 MFLOPS(约 0.16 GFLOPS)。这意味着,这批已被归为电子废料的十多年前二手电脑,在纸面指标上达到了传奇超算的 8100至9400倍。
跑分背后的偷换概念:向量巨兽碰上以太网拼凑机
算力堆叠可借陈年旧器,消弭通信鸿沟方见真章。
纸面数字虽然夺目,测试口径却暗藏玄机。该集群近期测试记录为 64 个活跃核心跑出 1.3 TFLOPS,此前 70 核全开时记录到 1.5 TFLOPS。对于核心数从 70 缩减至 64 的现象,外界报道解释为单台节点离线所致,但全机仅由双核与四核主机组成,单台设备停机在数学上无法直接扣减 6 个物理核心,这折射出其运行维护中的不可控状态。
更深层的差距在体系结构本身。Cray-1 之所以成为计算史上的神作,核心在于它的超低延迟:西摩·克雷将机身弯曲成 C 形,只为了将内部导线长度限制在几英尺以内,配合高带宽向量寄存器,让处理器无需忍受等待数据的停滞。
相比之下,西班牙团队搭建的是由两台千兆以太网交换机连接的松散标量集群。1.3 至 1.5 TFLOPS 的运算成绩,出自一套自编的 Python 矩阵乘法脚本。矩阵乘法具有极高的并行计算特征,运算任务分发后各节点独立计算,掩盖了网络传输的低吞吐和漫长等待。如果换用国际通行的超算基准 LINPACK 进行严苛的高性能线性代数联算,频繁的节点间数据交换会立刻撞上千兆网络的通信墙,实际效率将大打折扣。
- 风险.用高并行应用掩盖互联网络短板是分布式测试的常见技巧,自制跑分得出的峰值算力,无法等同于面向复杂通用科学计算的实际承载力。
现代芯片的降维反击与冲击TOP500的虚实
老硬件重获新生固然充满温情,但当代芯片技术的发展让这种粗糙拼凑显得更为苍白。根据针对现代 Apple Silicon 的学术测试,单颗 M4 芯片不仅 CPU 浮点性能达到 1.5 FP32 TFLOPS,其内置 GPU 更可达约 2.9 FP32 TFLOPS,并附带接近 100 GB/s 的超高统一内存带宽。一枚指甲盖大小的消费级芯片,在纯算力与数据吞吐两端,均已实质性超越整整 30 台旧 Mac 的集合体。
博物馆团队曾提出后续设想:发起众筹采购 70 至 80 台 M4 Mac mini 塞满剩余机位,尝试冲击全球超级计算机 TOP500 榜单。这一构想在传播上足够吸睛,但在严肃工程层面几乎没有落地空间。
| 设备体系 | 实测/理论浮点性能 | 互联网络与通信架构 | 内存带宽表现 |
|---|---|---|---|
| Cray-1 复刻机(30节点) | 1.3 - 1.5 TFLOPS | 双千兆以太网交换机(高延迟) | 各节点独立 DDR3,网络带宽受限 |
| 单颗 Apple M4 芯片 | 2.9 TFLOPS(GPU) | 片上超低延迟内部总线 | 统一内存吞吐近 100 GB/s |
| 当代 TOP500 榜首 El Capitan | 1.809 EFLOPS | 专用 Slingshot/高吞吐互联结构 | PB 级分布式超高带宽内存池 |
2026 年 6 月公布的全球 TOP500 榜单中,位居首位的 El Capitan 性能已达 1.809 EFLOPS(次席 Frontier 达 1.353 EFLOPS)。复刻集群与当今顶尖超算的差距在 140万倍 左右。更关键的制约在于互联方式:现代超算高度依赖 InfiniBand 或 Slingshot 等专有网络拓扑,将延迟压制在亚微秒级别。消费级 Mac mini 缺乏针对多卡并行和跨节点低延迟协同设计的物理接口,哪怕堆叠 80 台硬件,也会在多机互通的数据阻塞中动弹不得。
- 结论.将淘汰硬件改造成经典外形,是对计算文化极有价值的科普展陈;但若脱离低延迟互联去空谈超算性能与冲榜,就是把装置艺术误认成了前沿工程。