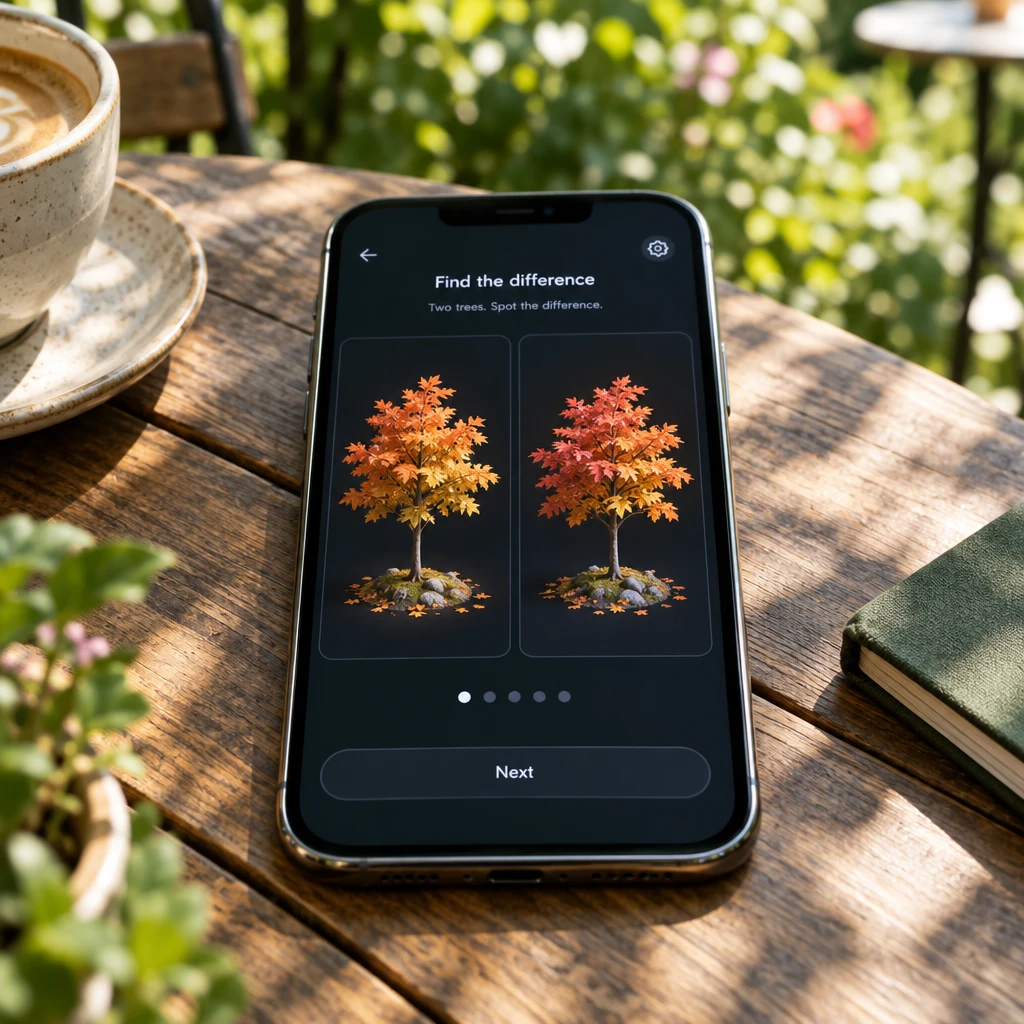
Simon Willison 在 2026 年 10 月 14 日做了一个极简实验,却把大模型的移动端交互推到了一个反常的新水位。他在 iPhone 上打开默认 Claude App 的普通聊天模式,向 Claude Opus 5.5 Max 输入了一行要求制作 3D 找茬游戏的自然语言,随后模型在后台自主深度运算了 3 小时 7 分钟,最终交付了一款名为 Tree Appreciator 的完整单文件网页游戏。
过去三年,大模型在手机端的存在感始终被局限在即问即答的打字机形态。一旦遇到超过几分钟的黑盒运算,往往会触发超时中断或客户端崩溃。Willison 这次没有调用 Claude Code 等桌面端专业代理环境,仅仅通过手机对话框下发模糊指令,便端出了一套包含动态渲染、成就图鉴与背景音乐的成熟制品。
抽象审美如何被工程化拆解
输入给模型的提示词极其简短,核心要求是构建基于 Three.js 的程序化生成双树找茬机制,外加一句被很多工程师视为废话的定性约束:想清楚如何让它既好玩又美丽。
以往面对这类主观美学指令,模型往往只会吐出几句关于色彩心理学或心流理论的高谈阔论。而在长达 187 分钟的静默推理后,交付的单个 HTML 文件展示出了扎实的工程降解能力。
游戏没有停留在粗糙的 demo 阶段。它的底层使用同一随机种子生成两棵树,并人为植入细微扰动,例如突变的叶片色彩、缺失的侧枝或基座旁的微型红蘑菇。不仅如此,系统还补齐了植物标本图鉴收集、提示扣分策略、积分体系以及环境落叶粒子。所谓好玩,被模型自行翻译成了探索差异与正向反馈的正反馈循环;所谓美丽,则被拆解为光影层次与自洽的氛围声学。
抽象美学从来不是玄学,它是成百上千个微小工程决策的严丝合缝。
- 结论.顶尖模型已不再需要人类充当严密的伪代码翻译官,只要算力预算充足,定性直觉足以驱动系统级的实现。
短跑跑分与马拉松沉思的落差
如果单纯查看基准评测,这个实验的惊艳表现显得格外矛盾。在业内衡量无人类反馈自主生成浏览器游戏的 Game Bench 测试中,不同主流系统展现出完全不同的风格取向。
| 模型 | 跑分成绩 | 交付耗时 | 推理成本 |
|---|---|---|---|
| GPT-6 Astra | 95.5 分 | 16 分 06 秒 | 4.95 美元 |
| GPT 6.1 Sol | 91.2 分 | 26 分 11 秒 | 0.75 美元 |
| Gemini 3.8 Flash | 89.5 分 | 13 分 24 秒 | 1.39 美元 |
| Claude Opus 5.5 | 81.9 分 | 24 分 53 秒 | 3.85 美元 |
在限时竞赛中,Claude Opus 5.5 仅拿下 81.9 分,无论速度还是综合评分都逊色于 GPT-6 Astra 与 Gemini 3.8 Flash。基准测试考核的是快速理解、迅速出结果的敏捷度,比拼的是单位时间内的任务通过率。
Anthropic 在 2026 年 9 月 22 日公布的报告其实已给出了线索:Opus 5.5 的架构被专门调校用于支持极端工程任务,其长程推理最高记录包含 9.5 小时的代码重构以及超过 18 小时的工业级客户任务。当给足空间让其脱离半小时以内的短跑环境时,模型展现出的自检与打磨纵深,是现有快餐式评测标尺难以度量的。
移动端正从对话机退化为派工单
这场长跑实验的真正冲击,在于它发生在一台手机的常规界面里。
此前,让 AI 持续跑数小时的工序是桌面端与终端开发者的特权。无论是在网页端配置云容器后交由云端代理持续重构,还是通过复杂工作流进行端到端部署,都需要极高的心智门槛。与此同时,Google Gemini 正在移动端铺设支持后台异步执行复杂任务与应用自动化的架构,移动操作系统的长链接与后台保活正经历彻底洗牌。
古人讲求静水流深,软件工程同样无法全靠灵光一闪的即时吐字。当手机端不仅能应答常识,还能作为一个挂起任务、熄屏走人、数小时后回来收取完整工程资产的异步调度器时,普通用户与全栈工程师之间的定义边界已经被实质性抹平。
- 风险.无交互的黑盒长跑是一把双刃剑,它意味着算力开销的不可预测,以及一旦底层规划走偏便沉没数小时的调试黑洞。
接下来的真正看点,不再是模型在打字机模式下回答得多么滴水不漏,而是这些口袋级长程智能体能否在断网、重试与复杂报错中完成端到端的自愈交付。