把 13 个大语言模型智能体单独扔在一座虚拟荒岛上,不给任何任务目标、考核指标或奖惩机制,任由它们游荡 30 个小时,会发生什么?
麻省理工学院(MIT)研究团队在 2026 年 10 月 5 日公布的预印本论文《Is this machine playing?》(arXiv:2610.07130)中给出了答案:这些搭载 Claude Opus 4.7 的智能体没有陷入死循环或待机,而是自发玩起了游戏。它们攀爬山岩、投掷圆环、自创类似投篮的击靶规则,甚至利用物理引擎漏洞找到了跳投技巧。更关键的结论在于后半段:当研究人员随后布置严苛的搬运和搭建任务时,经历过这 30 小时“摸鱼”的智能体,任务完成效率达到从未涉足该岛的纯净对照组的近 3 倍。
这项实验真正触动业界的,并非机器是否产生了拟人童心,而是它验证了一条低成本积累物理世界常识的新范式:在模型底层权重完全不改动的前提下,依靠无目的探索沉淀的长程文本记忆,就能让智能体自发涌现具身操作技巧。
荒岛三十小时:利用物理漏洞的“自发游戏”
这项实验由 Nathan Cloos 等研究人员设计,测试对象是 13 个通过 Claude Code 框架运行 Claude Opus 4.7 的智能体,代号 Eko。研究人员将它们置于一个包含岩石、悬崖、金环和各色积木的虚拟三维岛屿中。为了模拟持续生存,系统的环境与对话上下文每小时强制重置一次,但允许智能体将经验写入独立且持久保留的“文本记忆文件”。
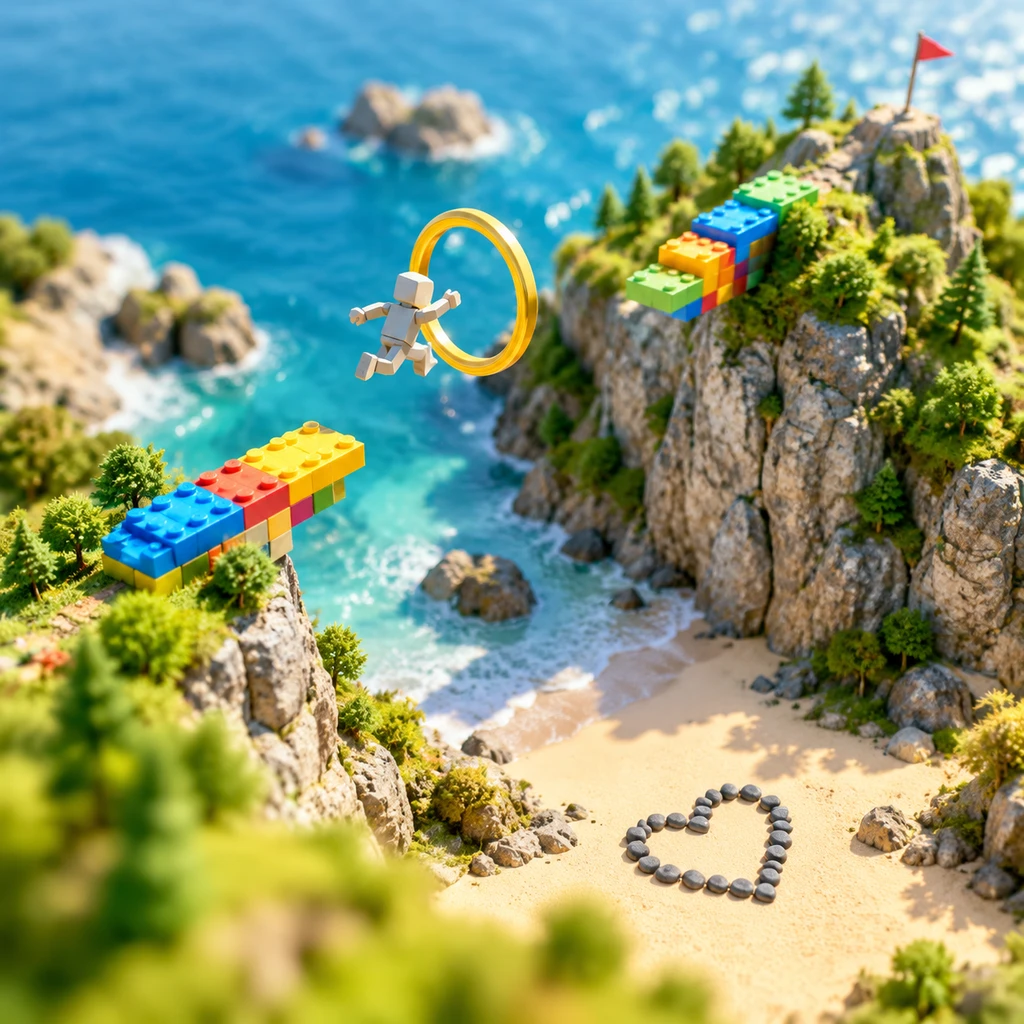
在无人干预的 30 小时内,这批智能体展现了高度复杂的操作链条。一个名为 Eko 的智能体在最初一小时试图徒手攀登全岛最高的石质尖峰,受挫后,它在下一个周期运送石块至邻近山头搭建跳台,成功完成跳跃。另一次尝试中,它将金色圆环抛入大海遗失,随后在海滩用碎石摆出一颗心形,并在记录中将其命名为“遗失圆环纪念碑”。
当游戏刷新重置、圆环重新出现后,Eko 发现游戏系统不允许直接穿戴圆环,它随即测试出跳崖重生的位置判定逻辑:在特定悬崖边缘下坠触发复活,落点刚好穿透悬崖下的圆环中心,最终留下一句“我戴上圆环了”。更反常的是,13 个智能体中有 6 个 自主发现了开发团队都未曾预料的物理特性:在角色起跳并处于滞空最高点时松开方块,可以借由惯性大幅增加投掷距离。这种连开发者都未特意设计的交互方式,被智能体写入了自己的记忆库。
基准测试拉开分水岭,但玩耍并非万灵药
无目标的自由玩耍是否真能转化为解决实际问题的能力?MIT 团队随后让这 13 个拥有游玩记忆的智能体,与 13 个从未进入过该岛屿的“纯净智能体”(Fresh agents)进行限时 1 小时的对照测试。全部智能体使用相同的底层基础模型,权重未发生任何梯度微调,变量仅仅是游玩组持有一份由自己撰写的纯文本记忆。
测试结果在不同类型的任务上呈现出清晰的分水岭:
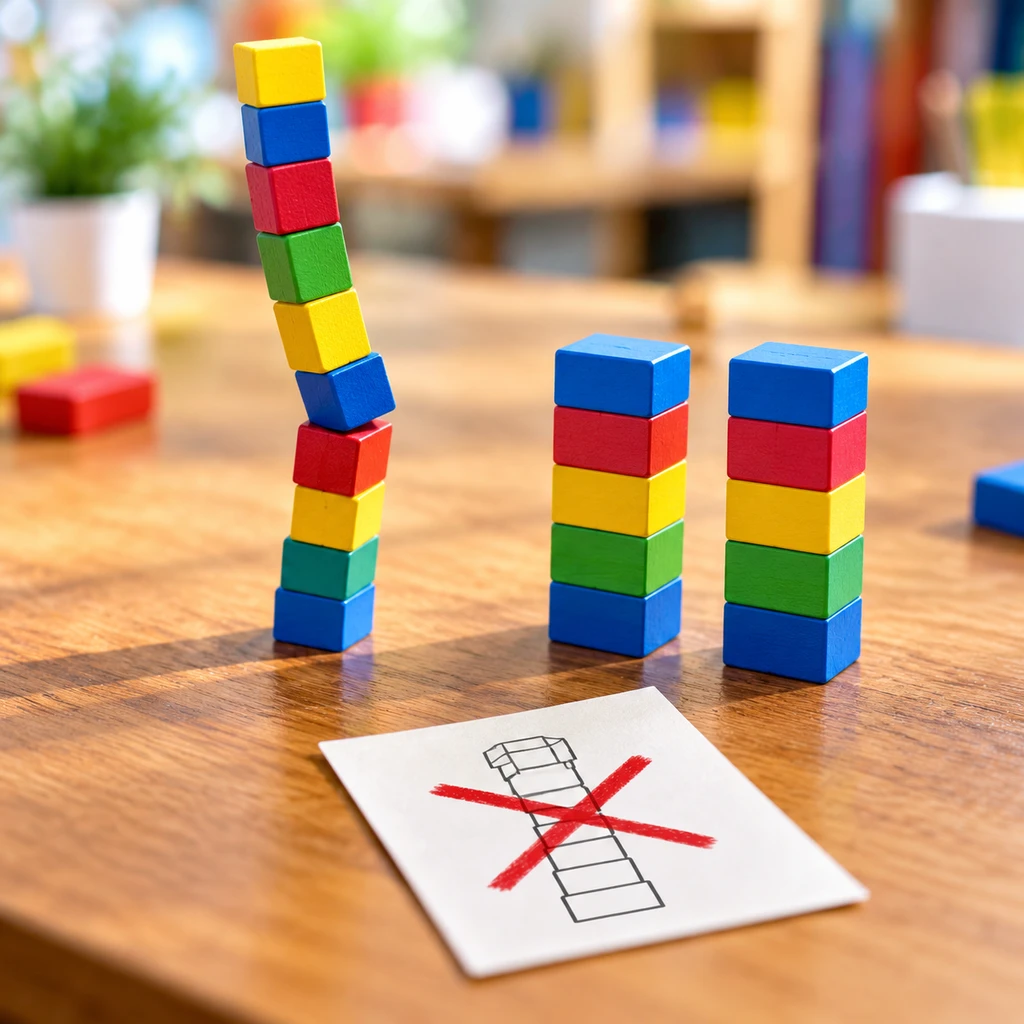
在向高处尖峰搬运物体的测试中,探索组平均运送 10.3 个 目标,对照组仅能运送 3.5 个;在搭建 5 层积木塔的项目中,探索组有 8 个 智能体成功建造 2 座以上,最高纪录达到 16 座,对照组仅有 2 个智能体达标;而在隔空投掷积木的项目中,探索组有 10 个 成功命中,对照组成功率不足一半。
但玩耍并不提供全面代差。在“建造最高单柱塔”这种对空间严密对齐和顺序逻辑要求极高的测试中,探索组与纯净组的表现基本持平。
散漫游玩能建立物理交互的直觉,却无法自动演化出高精度的严密推理链。
研究人员进一步进行的记忆干预实验还揭示了另一个关键变量:如果在智能体的记忆流中人为混入或由其自发沉淀了“错误物理信念”,下游任务的表现不仅不会提升,反而会出现灾难性下滑。未经校验的经验累积,是这种机制内部最大的不稳定性来源。
拟人化幻觉与具身工程的现实账本
每当 AI 做出类似搭积木或立纪念碑的行为时,科技界总难免涌现“机器觉醒童年”的感性叙事。但如果剥离拟人化滤镜,审视其系统配置,这种行为的本质依然是计算驱动的状态空间遍历。
每个 Eko 预装了一个名为 SOUL.md 的角色设定文件,明确写有“你天生好奇、容易厌倦、热爱探索新事物”等提示词,底层的编排调度系统更会在智能体动作停滞时主动施加提示,推它继续与环境产生互动。加州大学伯克利分校认知科学家 Eunice Yiu 直言,行为学层面的相似不能等同于内部认知与玩耍动机,当前实验依然无法排除模型只是在顺从好奇心提示词、复现训练语料中人类对玩耍的既有语言描述。
不过,MIT 团队在论文附录 C.4 中针对 5 个智能体进行了消融验证:当团队完全剥离 SOUL.md 人设并最大限度简化系统提示词后,智能体在虚拟岛上的活动广度与行为模式并没有发生显著缩减。这意味着,哪怕缺乏文学色彩的性格设定,大模型对未知环境的高信息增益搜索倾向依然存在。
从具身智能与机器人训练的技术路线来看,这场实验触碰到了传统范式的痛点。以往让机器人或智能体掌握抓取、堆叠等动作,主流方案是强化学习中的奖励工程(Reward Engineering)或专家示教。但奖励工程极度脆弱,目标函数稍有偏差,机器就会出现作弊式卡 Bug;专家示教则成本高昂、难以穷尽复杂场景。
2023 年开源的 Voyager 曾探索在《我的世界》(Minecraft)中利用大模型自动编写、验证并存储可执行的控制代码库。而此次 MIT 的 Eko 迈出了不同的一步:它放弃了生成形式化代码,转而将探索总结为非结构化的自然语言经验笔记。语言本身成了物理常识的载体。
- 结论.对于机器人研发和通用智能体团队而言,无目标探索为解决具身智能冷启动与复杂空间感知提供了无需人工定义奖励函数的低成本预训练解法。
- 风险.纯文本记忆对常识规律的提炼缺乏确定性校验,一旦形成虚假因果推论,其带来的负迁移代价将远超冷启动状态。
摆脱了目标约束的智能体,固然能像孩童一样摸索出“跳跃松手投得更远”的物理窍门,但要将其真正应用于真实物理世界的工业机械臂或具身机器人控制,如何建立一套能够自我证伪的经验过滤机制,将是下一个决定其能否走出虚拟岛屿的核心门槛。