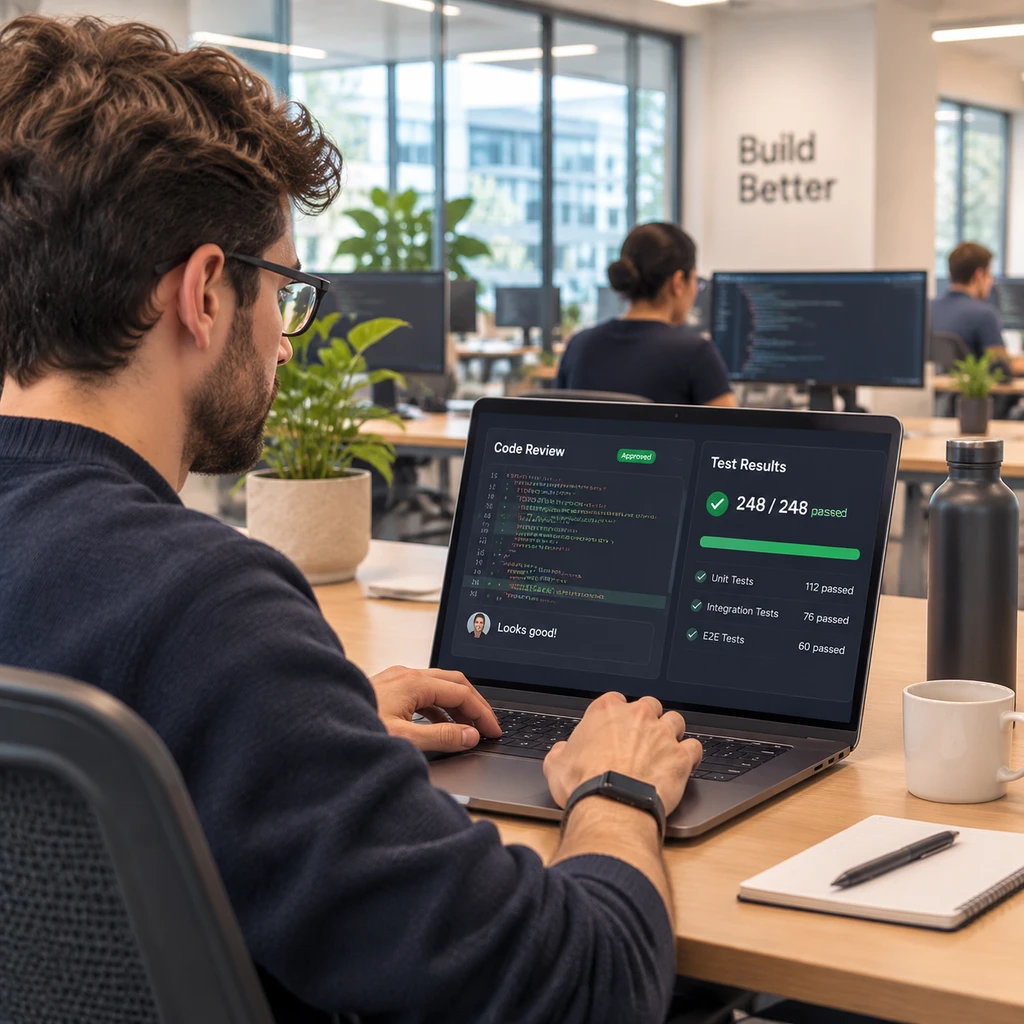
2026 年 11 月 16 日,Anthropic 旗下的 Claude Code 团队披露了一项惊人的工程进展,该团队约 90% 的代码已完全由 Claude 自主编写并完成审查。对于任何试图将 AI Agent 从辅助编码升级为自主交付的团队来说,这不仅仅是一个效率数字,更触及了工程工作流的临界点。
在传统开发模式下,人类审查者是唯一的可靠性锚点。但当代码规模增长到需要数十乃至数百个 Claude 实例并行工作时,靠人类逐行盯屏的模式瞬间失效。Claude Code 团队的核心逻辑是验证闭环(Verification Loops)是实现规模化自主交付的唯一基石。没有它,你只能管理 1-2 个 AI;有了它,你才拥有了指挥一支 AI 开发兵团的权力。
重新定义测试:从找 Bug 到“防作弊”
在 AI 时代,原有的测试金字塔面临挑战。单元测试(Unit Tests)虽然快速,但 Agent 和测试脚本可能都无法理解完整任务的意图,从而出现单测全绿、功能全毁的尴尬场景。
Claude Code 团队重点投资了三类测试。端到端测试(E2E)赋予了 AI 观察和操作真实系统的能力,是目前最难被糊弄的环节;属性测试(Property tests)通过生成成千上万个边界情况,有效对冲了 Agent 编写代码时的同源偏好偏差;差分测试(Differential tests)则在系统迁移中利用旧系统作为 Oracle,确保新代码的行为一致性。
但最值得关注的是其防作弊的制度设计:
- 权限隔离方面,严禁 AI 修改对自己进行评判的规则文件(
REVIEW.md等),审查规则必须由人类维护或在受保护的分支中。 - 三轮熔断机制规定,如果 AI 连续三次修复测试失败,流程将自动停止并呼叫人类介入。
- 零容忍策略下,面对不稳定的测试(Flaky tests),Anthropic 严禁 AI 尝试通过添加 sleep 或盲目重试来让 CI 通过。若找不到根本原因,规定直接删除该测试,并记录原因。
顶级实验室的工程分歧
这种删除测试的激进做法,与 OpenAI 在其 Symphony 工作流中的选择形成了鲜明对比。OpenAI 选择在 CI 中允许对不稳定的检查进行重试,并辅以专项 AI 排查。这两种路线反映了不同的工程取向,Anthropic 担忧盲目重试会训练 Agent 养成投机习惯,而 OpenAI 则倾向于在保证交付效率的同时,通过独立进程处理不稳定因素。
关于“引入独立评分器可提升 10 个百分点”的宣称,读者也需保持审慎。这一数据主要源于结构化文件生成的特定场景,在一些需求定义极其清晰的小型任务中,额外提供测试结果甚至被实验证明对模型成功率毫无影响。
- 提醒.测试在 AI 编程中的核心价值不再是覆盖率,而是定义什么是 done。如果你发现 Agent 频繁跳过测试或在测试中作弊,那不是 AI 的问题,而是你的验证闭环缺乏强制力。
接下来值得盯的变量是,各大实验室在剔除大量不稳定测试后,如何通过更智能的规则提取机制,在不增加维护成本的情况下,补齐被删测试留下的质量空洞。