AI行业讨论Scaling已经很久了,但很少有人把讨论的主角从算法工程师换成电力工程师。Cerebras联合创始人Andrew Feldman走上TechCrunch Disrupt 2026的讲台,抛出一个直白的问题:当芯片算力逼近物理极限,AI到底还能不能继续变大?这不是形而上的学术思辨,而是一家刚拿了大钱的芯片硬件公司在算自己的履约账期。
资本市场给出的回应很慷慨。2026年5月13日,Cerebras以每股185美元为其纳斯达克IPO定价,挂牌代码为CBRS。在基础发行筹集约55.5亿美元后,承销商全额行使了450万股超额配售权,招股文件Form 424B4最终锁定的总募资额达到约64亿美元。手握巨资的同时,Cerebras早在1月就与OpenAI签下一份750兆瓦(MW)的多年算力供应协议。然而,这种用整张晶圆做芯片的非主流路线,真的能接管英伟达统治的算力帝国吗?
晶圆级降维打击与三十倍的宣传温差
传统芯片的逻辑是把300毫米硅晶圆切成数百颗独立Die,再用基板与铜导线拼成卡,装上交换机组成集群。这种架构不可避免地撞上片间通信瓶颈与内存墙。Andrew Feldman在微服务器厂商SeaMicro被AMD收购后,于2015年创立Cerebras,坚持晶圆级计算路线,直接把一整张未切割的晶圆做成超大处理器。
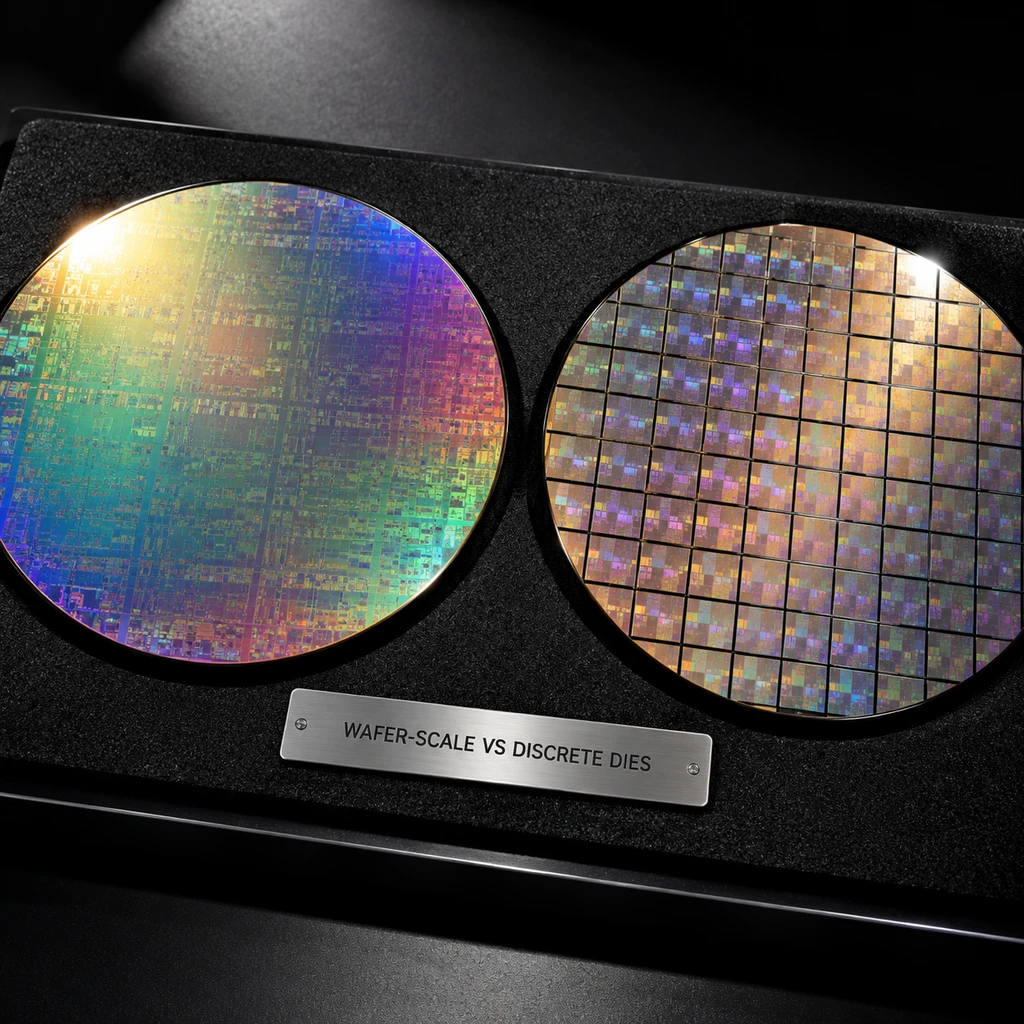
作为技术锚点,上一代CS-3系统搭载的WSE-3芯片面积达到46,225平方毫米,采用5纳米制程,集成了约4万亿晶体管与90万个AI核心,片上SRAM容量为44 GB,内存带宽达到21 PB/s,单台系统最大功耗即达到23 kW。8月亮相的新一代CS-4系统进一步推高了集成度,Cerebras对外宣称其部分性能指标高出通用GPU达30倍。
这30倍的含金量需要剥离水分来看。Cerebras的高速优势主要体现在单用户的输出交互延迟,也就是解码速率。因为所有核心都在同一张硅片上,信号传导没有走PCB板和以太网的迟滞。但在多用户并发请求的集群总吞吐量,以及长上下文处理场景下,官方并未给出同等模型精度与同等真实工作负载下的对比基准。
晶圆级芯片击碎了板卡间的通信墙,却把自己锁进了片上SRAM的方寸之间。
这也解释了OpenAI的采购动机。监管文件披露,OpenAI签署的750 MW算力协议明确聚焦于高速推理,并采取严谨的分阶段交付:2026年底前交付250 MW,2027年底前累积交付500 MW,2028年底前最终完成750 MW部署。对于万亿参数模型,仅有几十GB片上缓存的WSE根本无法直接容纳全部权重,必须靠外部系统把权重动态流式刷入晶圆。在8月的Hot Chips技术峰会上,Cerebras承认了这种限制,并透露将在CS-6规划中探索3D垂直堆叠内存。
算力狂飙撞上物理电网
走出芯片架构的微观世界,Scaling面临更残酷的宏观物理约束。在半导体行业狂奔的同时,公用事业电网正在成为硬门槛。
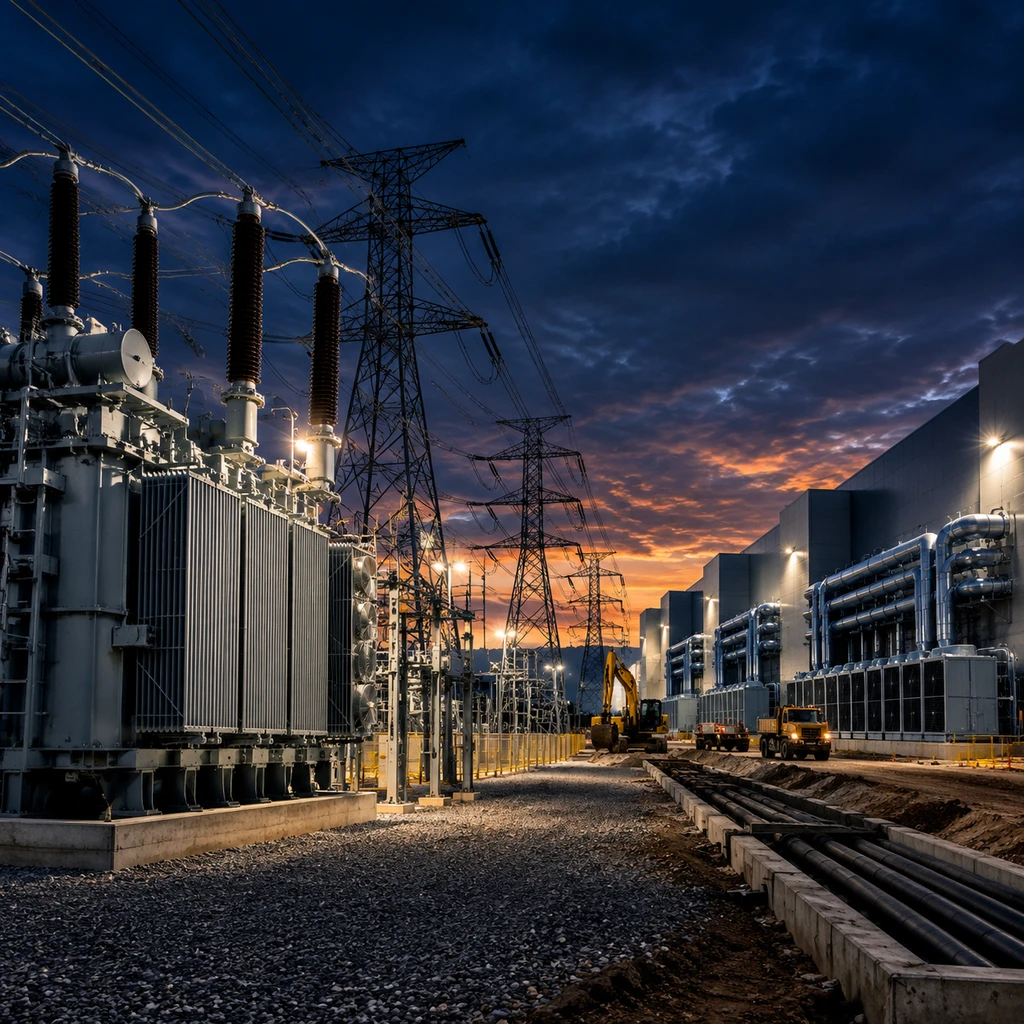
Cerebras规划在2026年将制造产能提升10倍以上,在2027年底前交付超过600 MW数据中心容量,并计划在欧洲拓展200 MW容量。但把数百兆瓦的算力连入电网,远比在晶圆厂下订单慢得多。变电站扩容审批、高压变压器采购以及输电线路负荷,动辄需要三到五年的等待周期。
国际能源署(IEA)的数据揭示了这道墙的高度:全球数据中心用电量将从2024年的约460 TWh,暴增至2030年的1000 TWh以上,到2035年基准情景下将达到1300 TWh。一个持续满载运行的100 MW数据中心,年耗电量约0.876 TWh;而一座1 GW级别的超大规模园区,年耗电量高达8.76 TWh。
- 风险.当每台服务器功耗动辄数万瓦,算力密度的提升迫使机房必须依赖高定制液冷;若地方电网配电互连滞后,空有十倍产能也只能停在仓库。
芯片性能不再单凭理论浮点数决胜负。OpenAI首批250 MW系统的上线交付将于2026年底迎来实测检验。如果Cerebras不能在真实电力成本下提供具有说服力的每瓦有效Token产出,晶圆级架构就很难从专用的推理加速器演变为通用基建的主流选择。