大语言模型的底层研发长期被 Python 和 PyTorch 生态牢牢垄断,全栈与前端开发者在多数时候只能扮演调用 API 的外围角色。开源项目 Building an LLM in NodeJS 近期在 Hacker News 受到广泛讨论,开发者试图通过 Node.js 与 TypeScript 从零构建自回归 Transformer 模型,并利用浏览器端 WebGPU 运行交互演示。这是一场极具野心的教学实验,它撕开了模型底层的黑盒,但仓库代码也暴露了关键工程断层:完整的生成与训练管线仍未闭环。
拆解 Python 垄断:用 TypeScript 重组张量拼图
在主流认知中,剥离了 Python 生态和 CUDA 算子,脱手编写大模型几乎寸步难行。此前 Karpathy 编写的 nanoGPT 以及各类权威教材,均以 PyTorch 作为教学基石。面对自回归 Decoder-only 模型教学资源的匮乏,该项目选择绕过繁琐的 Python 环境配置,纯粹使用 Web 技术栈搭建整套体系。
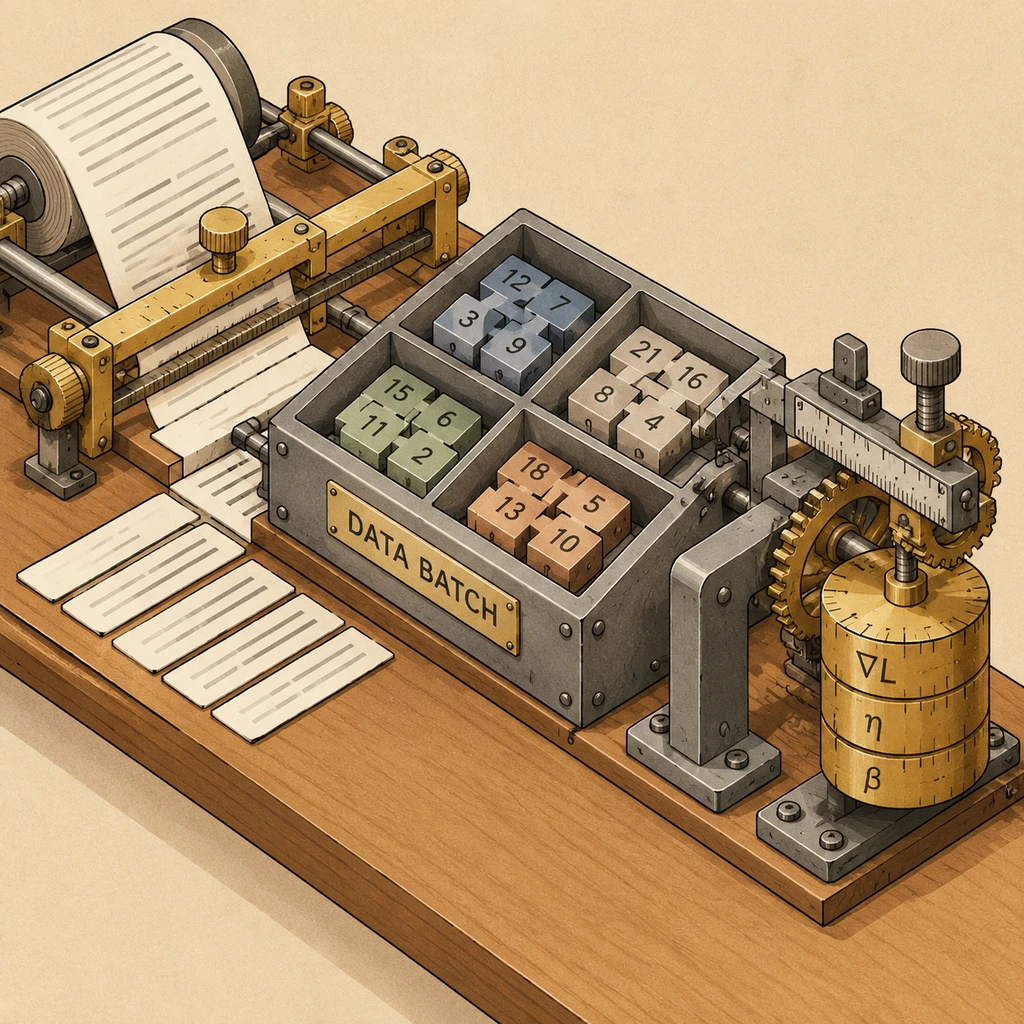
pnpm ch02(分词与数据) -> pnpm ch03(注意力机制) -> pnpm ch04(前向传播) -> pnpm ch05:train(模型训练)为规避纯 JavaScript 浮点数计算的性能瓶颈,项目底层张量计算依赖 Google 的 TensorFlow.js,在 Node.js 环境中通过 @tensorflow/tfjs-node 直接调用底层原生加速。基础文本处理没有直接调用成熟打包方案,而是手写了一套 BPE 分词器,并与业界成熟的 gpt-tokenizer 进行编码对齐验证。
针对训练数据流,项目设计了支持滑动窗口的 Dataset,配合具备批量(batching)与洗牌(shuffling)能力的 DataLoader。在最具挑战性的反向传播环节,项目摒弃了黑盒包装,显式使用 tf.variableGrads 计算损失函数对各层权重的梯度,再由 optimizer.applyGradients 执行参数迭代。
过去业界虽然出现过 nunsie/transformers 等 TypeScript 实现,但多数局限于早期 Encoder-Decoder 结构。专为现代 GPT 类自回归 Decoder-only 架构定制的实现方案,在 JavaScript 社区中一直属于空白领域。
剥开开源光环:核心章节仍在施工中
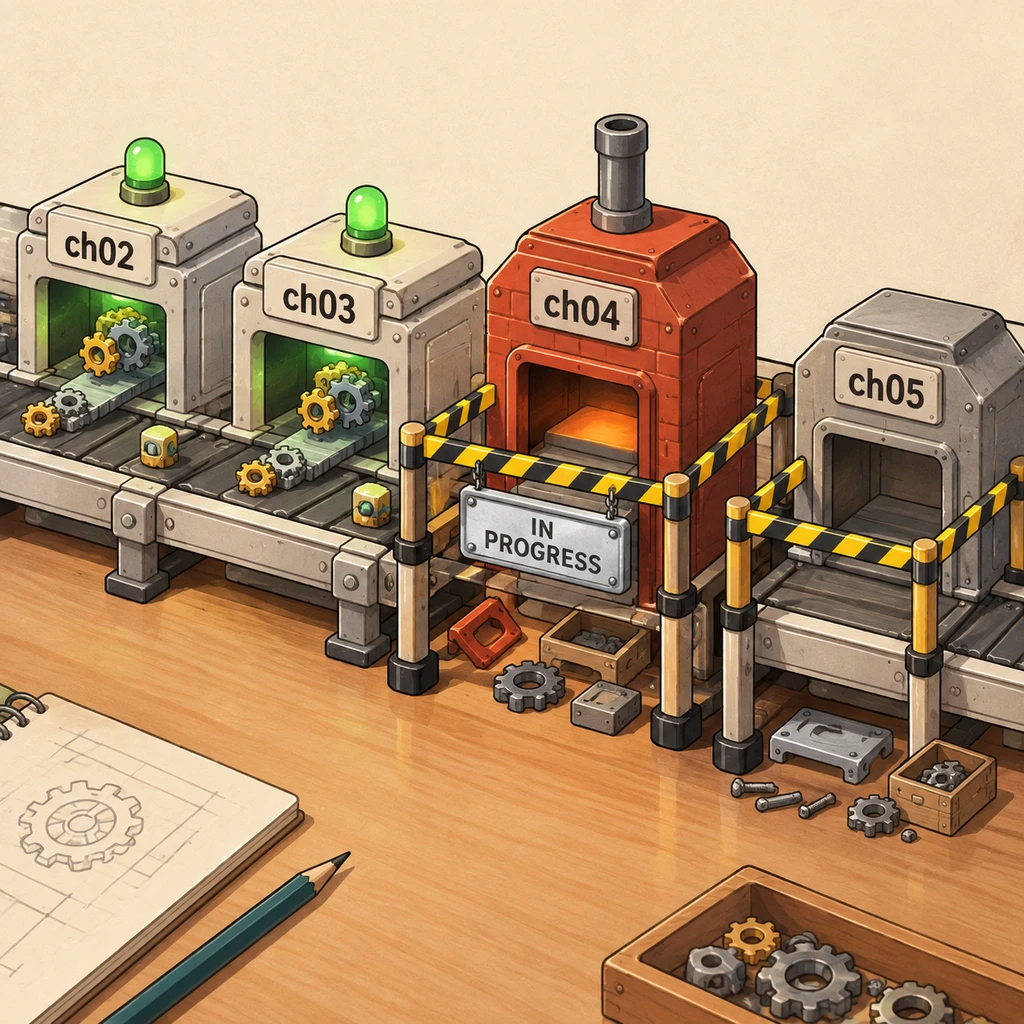
尽管在线图书宣称覆盖了从分词器到训练循环的全流程,但代码仓库暴露了当下真实的研发进度。项目尚未完全交付,其完整度呈现出明显的断层状态。
这是一套极佳的原理教具,但绝不是拿来即用的生产级框架。
从配套仓库 BaraaSoft/node-llm 的提交记录来看,分词器、词嵌入与多头自注意力机制章节已具备运行能力,通过 pnpm ch02 和 pnpm ch03 即可执行验证。然而,第四章的 GPT 整合模型、第五章的训练循环脚本 pnpm ch05:train,以及文本生成模块,在仓库中仍被明确标注为开发中(in progress)。更关键的是,仓库截至目前未公开具体模型参数量,意味着模型的最终收敛表现和实际算力消耗仍处于黑盒状态。
- 提醒.如果计划将其引入生产环境或将其作为微调底座,目前的技术成熟度并不支持;大规模分布式训练和深度显存优化依然是 PyTorch 独占的壁垒。
终局不在工业级替代,而在认知平民化
既然在算力和分布式训练上注定无法与 Python 生态竞争,为什么用 TypeScript 重写一遍 Transformer 仍有价值?
核心变量在于跨平台的普及门槛与认知平民化。在工业级预训练场景之外,全球数千万前端与全栈开发者正被隔离在模型原理的围墙之外。项目规划了基于 @node-llm/playground 的浏览器端 WebGPU 交互演示,这意味着使用者无需配置复杂的 CUDA 驱动,仅需现代浏览器即可直观查看张量流转和注意力权重分布。
- 建议.对于希望摆脱单纯 API 搬运工角色的全栈工程师,该项目是目前理解 Transformer 内部数学机制成本最低的路径之一。
后续评估该项目成败的关键,在于观察代码仓库何时完成 ch04 与 ch05:train 的代码合并,以及 WebGPU 演示页在主流浏览器中呈现出的实际显存占用与推理延迟。