字节跳动与多所美国大学推出开放模型 Axion 1.0,把能联网检索、运行代码并处理多步任务的智能体后训练压缩为三个阶段。论文于 2026 年 11 月 2 日提交至 arXiv,11 月 11 日修订。结果足以让训练团队认真考虑这条更短的路线,但要据此砍掉现有环节,还缺一组控制预算的重训实验。
Axion 1.0 把后训练压缩为三阶段
智能体既要推理,又要判断何时搜索、如何使用工具。训练团队常为这些能力增设环节,每加一环,就要多做一轮数据准备和评测,出了问题也更难追溯。Axion 省去了专门的中间训练、DPO(直接偏好优化)和在线策略蒸馏阶段,保留两轮监督微调和一轮强化学习。
首轮微调用 10,819 条数学与科学推理轨迹,训练模型在不借助外部工具时解题。第二轮转向工具依赖型推理,7,544 条工具使用轨迹合计约 3.12 亿 token。强化学习采用异步 GRPO,让模型调用网页搜索、页面访问、学术检索和 Python,并按最终答案及经过验证的中间进展给奖励。
<svg viewBox='0 0 760 200' width='100%' height='200' role='img' aria-label='Axion 三阶段后训练流程'>
<rect x='0.5' y='0.5' width='759' height='199' rx='14' fill='#fbf9f4' stroke='#e2dccf'/>
<text x='30' y='39' fill='#b25a3a' font-size='20' font-weight='700'>Axion 三阶段训练</text>
<line x1='30' y1='55' x2='730' y2='55' stroke='#e2dccf' stroke-width='1'/>
<rect x='30' y='84' width='200' height='86' rx='9' fill='#ffffff' stroke='#e2dccf'/>
<rect x='280' y='84' width='200' height='86' rx='9' fill='#ffffff' stroke='#e2dccf'/>
<rect x='530' y='84' width='200' height='86' rx='9' fill='#ffffff' stroke='#e2dccf'/>
<line x1='242' y1='127' x2='261' y2='127' stroke='#b25a3a' stroke-width='2'/>
<polygon points='261,123 269,127 261,131' fill='#b25a3a'/>
<line x1='492' y1='127' x2='511' y2='127' stroke='#b25a3a' stroke-width='2'/>
<polygon points='511,123 519,127 511,131' fill='#b25a3a'/>
<text x='130' y='119' text-anchor='middle' fill='#2c2822' font-size='18' font-weight='700'>自包含推理</text>
<text x='130' y='145' text-anchor='middle' fill='#7a7266' font-size='14'>首轮监督微调</text>
<text x='380' y='119' text-anchor='middle' fill='#2c2822' font-size='18' font-weight='700'>工具依赖型推理</text>
<text x='380' y='145' text-anchor='middle' fill='#7a7266' font-size='14'>次轮监督微调</text>
<text x='630' y='119' text-anchor='middle' fill='#2c2822' font-size='18' font-weight='700'>工具交互</text>
<text x='630' y='145' text-anchor='middle' fill='#7a7266' font-size='14'>强化学习</text>
</svg>
强化学习有得有失,阶段贡献还难归因
论文评测了 Axion 1.0-35B 和 Axion 1.0-122B,总参数分别为 350 亿和 1,220 亿,激活参数分别为 30 亿和 100 亿。完整 Humanity’s Last Exam(HLE)上,两版分别得 52.2% 和 59.0%。到了 SEAL-0,35B 以 62.2% 高过 122B 的 58.6%。
在 HLE-130 子集上,从基础模型走完三阶段,35B 由 47.7% 升至 70.0%,122B 由 40.8% 升至 74.6%。强化学习改善了 HLE-130 和 SEAL-0,但在 FrontierScience Research 上,35B 经两轮微调从 26.7% 升到 58.3%,强化学习后回落至 56.7%,降了 1.6 个百分点。122B 在同一评测中从 40.0% 升至 66.7%。
论文明确把这些数字界定为检查点对比。它能看出成绩在哪一站变动。要判断第二轮微调能否省掉,还得用等量 token 替换工具轨迹,控制算力和工具环境,再跑完后续训练。
<svg viewBox='0 0 760 205' width='100%' height='205' role='img' aria-label='阶段检查点对比与受控删减实验的区别'>
<rect x='0.5' y='0.5' width='759' height='204' rx='14' fill='#fbf9f4' stroke='#e2dccf'/>
<text x='30' y='39' fill='#b25a3a' font-size='20' font-weight='700'>删减证据还差一步</text>
<line x1='30' y1='55' x2='730' y2='55' stroke='#e2dccf' stroke-width='1'/>
<rect x='30' y='82' width='335' height='93' rx='9' fill='#ffffff' stroke='#e2dccf'/>
<rect x='395' y='82' width='335' height='93' rx='9' fill='#ffffff' stroke='#e2dccf'/>
<text x='53' y='117' fill='#2c2822' font-size='18' font-weight='700'>已做检查点对比</text>
<text x='53' y='147' fill='#7a7266' font-size='14'>沿途分数变化</text>
<text x='418' y='117' fill='#2c2822' font-size='18' font-weight='700'>待做受控删减</text>
<text x='418' y='147' fill='#7a7266' font-size='14'>同等预算重训</text>
</svg>
网页访问范围会改写榜单成绩
取消网站限制后,完整 HLE 上的 35B 从 52.2% 升至 59.1%,122B 从 59.0% 升至 64.8%。论文使用特定的搜索、页面检索、学术检索和 Python 工具,取最佳单次成绩。这些分数衡量的是模型与工具的组合,无法说明模型操控图形浏览器的水平。企业若要拿它做研究检索,多次运行的平均完成率、工具失败后的恢复能力,比单次峰值更能指导选型。
社区的一项编码测试关闭思考模式后,Axion 35B Q8 与 Qwen3.6-35B-A3B 在 100 道独立题中均完成 93 道,Qwen3.8-27B 完成 92 道,标注为 DeepSeek Flash 的云端模型完成 100 道。这个横向对照限于独立题,真实代码仓库里的定位、修改和回归测试仍待验证。
公开权重和训练账单都要核对口径
可下载的 Axion 1.0-35B 是社区复现版,它在 SEAL-0 上报告 60.4%。62.2% 属于论文评测的官方检查点。项目公开了训练和数据生成代码、部分监督微调数据及评测工具,跑完整评测仍要接入外部工具、收集交互轨迹。
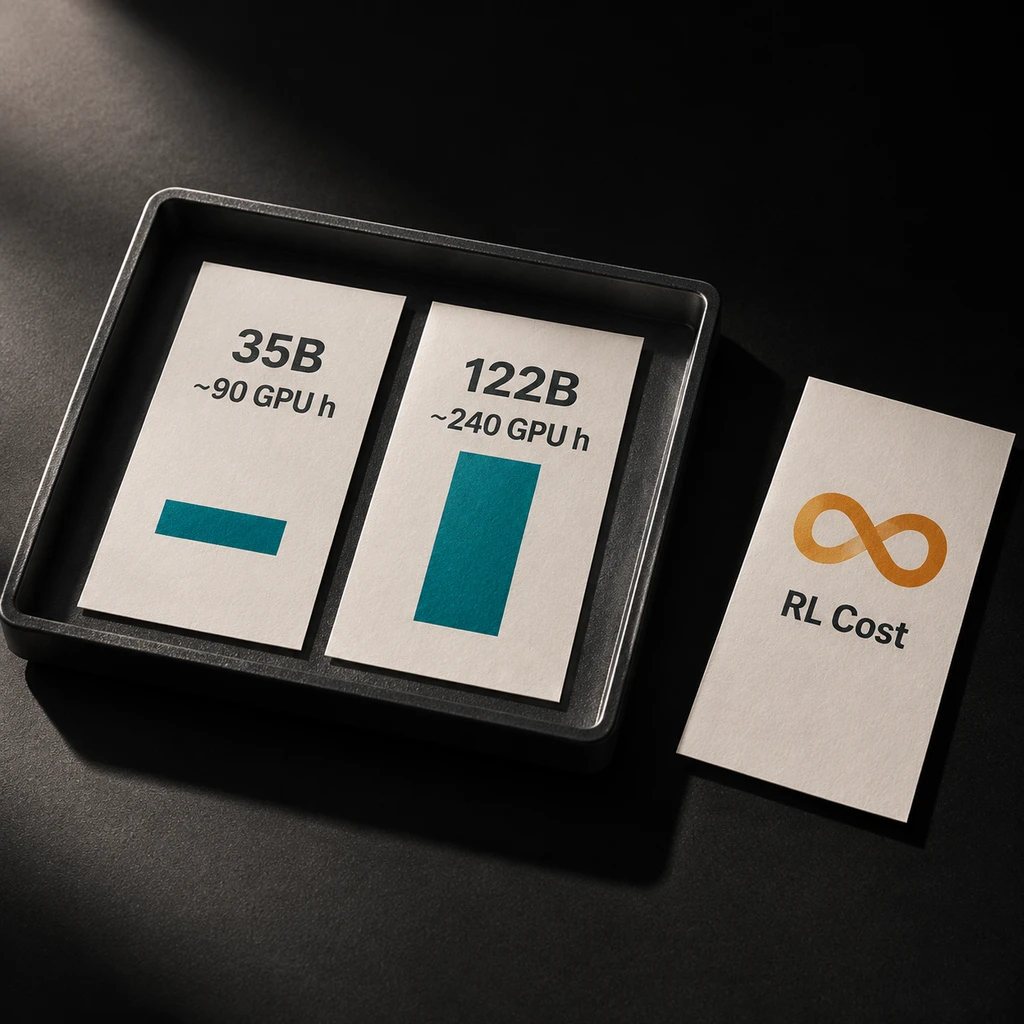
两轮微调均在 32 张 GPU 上完成,35B 约用 90 GPU 小时,122B 约用 240 GPU 小时。两笔数字均未计强化学习。训练团队能否据此缩减预算,要看把交互采样、工具服务和评测算进去之后,同等任务完成率对应的总成本。