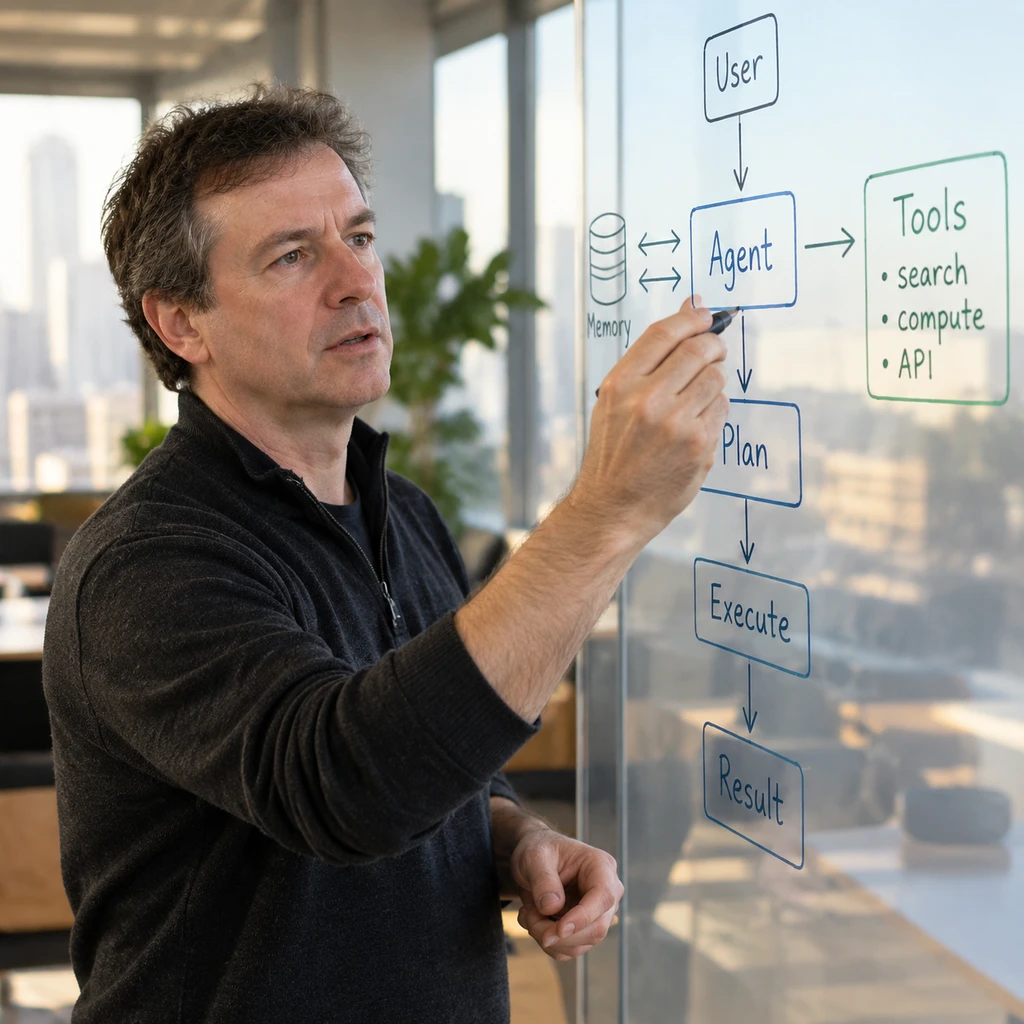
为了让智能体选一个工具,或者判断一条工单该不该放行,很多团队还在调用千亿参数的云端大模型,逼着它们逐字吐出一长串思考词和带括号的标记。这种做法又慢又贵,一次简单的路由往往要白耗数百毫秒甚至数秒,还动不动就因为少了个引号导致下游解析直接崩溃。
AWS 旗下的 Strands Labs 决定直接动刀。他们开源了决策模型 Strands Decider 2B,把预训练语言模型的自然语言生成头连根拔掉,换成只有约 100 万参数的指针头。原本拖沓的逐字生成,被强行压缩成单次前向计算。
在本地单张英伟达 RTX 3090 上,它的中位响应延迟压到了 115 毫秒;哪怕在苹果 M3 芯片的笔记本上跑,延迟也只有 153 毫秒。但代价同样惨烈:一旦遇到高难度的多跳因果与数值计算,它的准确率直接跌破 30%。
拔掉生成头,用单次前向换取百毫秒极速
在多智能体流水线里,协调层的任务本质上是选项分流,不是写散文。强求自回归模型逐字吐出结构化文本,既耗费显存带宽,也容易引发语法解析灾难。
Strands Decider 2B 基于 Apache-2.0 协议开源,底模选用约 19 亿参数的阿里 Qwen3.5-2B-Base。工程团队没有从头预训练,而是做了一次极为克制的外科手术:
- 切除语言建模头彻底剥离底层用于输出词表概率的 LM Head,主干部分配合 Rank-16 LoRA 进行轻量微调。
- 挂载专用读出指针在 Transformer 最后一层隐状态上,接入约 100 万参数的指针与读出头。
- 固化决策范式输出被锁死在是非判断、多选一和有序量规打分这三类结构化概率,不再预测下一个词,而是计算选项与回答位置隐状态的相似度。
这套改动的训练成本低得惊人。在单台英伟达 H100 80GB 主机上,官方实际训练时间仅用了 1,685 秒,也就是 28 分钟左右。即便用单张消费级 RTX 3090 复现,大约 11 个小时也能跑完。训练数据混合了 ContractNLI、MuSiQue 基准集、合成检验数据,以及冻结的 Qwen3.5-4B 教师模型给出的软目标。
不用维护自回归解码缓存,也不做逐词采样,系统在本地单张 3090 上跑出了 115 毫秒的中位延迟,P95 延迟为 299 毫秒。它不再是个能聊天的语言模型,而是一个被强行改造成单次前向分类器的极速道岔。
穿透基准:简单任务满分,复杂推理腰斩
跑得快,不代表选得准。
在涵盖 231 道测试题的 JevBench 公开测试集上,官方基准权重 hobson-v19 命中 167 题,综合准确率为 72.3%;后续演进的 v21 版本微升到 176 题。
剥开任务难度,断层非常刺眼:
| 评估指标 / 任务分级 | OpenAI GPT-5.6 Luna | TypeSafe Jev 1.13 | Strands Decider 2B (v19) |
|---|---|---|---|
| 公开集综合准确率 | 97.1% | 96.3% | 72.3% |
| 简单任务准确率 | 99.4% | 99.1% | 100% |
| 标准任务准确率 | 97.8% | 96.5% | 87.5% |
| 高难任务准确率 | 94.2% | 93.3% | 50.5% |
| 多跳推理准确率 | - | - | 44.4% |
| 长策略文档匹配 | - | - | 36.8% |
| 时序与数值计算 | - | - | 26.7% |
| 调用时延 (中位数) | 0.98秒 | 0.65秒 | 0.115秒 |
在规则直白的单步分流任务上,它拿下了 100% 满分。但只要遇到需要多步因果推导的高难任务,准确率直接跳水到 50.5%。在一个主要由是非题构成的测试集里,拿到 50.5% 的准确率,意味着模型基本是在抛硬币。
更细分的数据更难看:多跳推理只有 44.4%,长策略文档匹配跌到 36.8%,涉及前后时序与数值计算的任务仅有 26.7%。失去逐词思考缓存的 2B 躯干,一旦面对两层以上的逻辑嵌套,指针头只能靠隐状态做粗暴匹配。
而且它的语义敏感度很钝。给同一套业务意图换一种问法,输出的概率分布经常纹丝不动;面对模糊输入时,它甚至会以 0.72 的高置信度笃定地选出错误项。
统计校准的假象与落地硬伤
官方在文档里重点强调了置信度校准能力。v19 的期望校准误差(ECE)为 0.050,v21 为 0.064,Brier 分数保持在 0.32 到 0.34 区间。
这里存在一个工程陷阱:统计上的校准度,绝不等于单次调用的可靠性。
ECE 优秀,只说明当模型给出 80% 的置信度时,在一万次测试里大约有八成样本能命中。但回到具体业务,你拿到的依然是一张黑盒彩票。由于彻底放弃了自回归吐字,它不输出任何推理步骤。工程团队拿到一个漂亮的置信度数值,根本查不出它究竟看了哪句话。
在未见泛化测试集上,只有置信度大于等于 0.9 时,准确率才能达到 95.2%。但这种高置信场景,仅仅覆盖了 23% 的业务样本。剩下接近八成的长尾请求里,它给出的分数并不值得托付。
除了模型本身的判断极限,工程部署还有两个必须正视的现实约束:
- 4,096 tokens 的硬性上下文窗口:智能体排查故障或调度工具时,如果传入的历史调用链稍长,截断机制会直接切掉前面的前置条件,导致误判率飙升。
- 本地服务缺少内置鉴权.官方提供的服务形态极为精简,一旦直接丢在多租户环境或内网公共网段,就会沦为毫无防护的暴露节点。
级联兜底:别把高速道岔当终审大脑
消除了 JSON 语法解析错误,并不代表业务逻辑成立。交付了一个格式合法的枚举值,里面装的却是一个致命的误判,在生产链路里更加隐蔽,也更难排查。
铁路调度系统很早就解决过类似的问题:道岔机械机构的动作时间可以精确到秒级,但何时变轨、放行哪趟列车,永远由后方的闭塞区间和调度台说了算。
《孙子兵法》讲:“多算胜,少算不胜,而况于无算乎?”砍掉生成头换来了百毫秒响应,却也剥除了模型进行逐步验算的算力空间。
Strands Decider 2B 的价值,在于安放在调度网关的最前端充当低成本粗筛阀门。对常见的高频意图就地分流,一旦置信度跌破阈值、文档超过窗口限制,或者涉及资金划转与数据删除等不可逆操作,立即静默交回大尺寸通用模型。
在多智能体流水线里,它是一把极趁手的快刀,但它替代不了真正的思考中枢。懂得在什么时候分流、在什么时候交出控制权,才是工程确定性真正的压舱石。