2026年11月16日,苹果公布了一项名为 Apple Health AI Usage Study 的新研究,联手医疗专业临床 AI 平台 OpenEvidence,在全美招募最多 200,000名 21岁及以上的参与者,测试对话式 AI 健康工具的回答到底有没有用。参与者在运行 iOS 26 及以上系统的 iPhone 15 Pro 上下载专用应用,用文字或键盘听写提问,系统会调用《新英格兰医学杂志》等同行评审临床文献生成通俗解答,由用户对准确性、细节和相关性打分。耐人寻味的是,这款应用完全绕开了 Siri 和 Apple Intelligence,用户可自愿授权步数、睡眠或化验单等 HealthKit 数据补充上下文,且数据不用于训练模型;而翻遍苹果机器学习官网,截至11月16日也未见当月同名的底层模型论文,真正支撑苹果健康野心的,其实是过去一年半里那套高达 25亿小时 的传感器基础模型矩阵。
一边是用外部医学文献搭台做前台问答测试,另一边是在后台用海量手腕传感器数据狂飙底层特征模型。把这两条线拼在一起就会发现,科技媒体口中“提高 AI 健康工具有效性”的宣传,与严肃医学要求的临床有效性之间,还隔着一条巨大的鸿沟。
传感器跑分不等于看病疗效
要看懂苹果在健康 AI 上的真实家底,得看它先后交出的四份底层研究答卷。最新的一份是2026年7月发布的《Emergent Symbolic Structure in Health Foundation Models》,研究团队用约172,000名参与者、约2000万分钟的传感器数据做预训练,并在30,000名受试者的保留队列上做分析,发现把学习到的信息在光学脉搏传感器(PPG)与加速度计之间迁移,可以保留超过 95% 的原传感器模态性能。再往前看2025年2月的加速度计基础模型研究,同样用约172,000人、2000万分钟数据,在心率和心率变异性预测上比对比编码器提升了23%至49%,从加速度计表征去匹配光学传感器表征的 top-1 准确率甚至高达 99.2%。
真正挑大梁的是2025年6月30日发在预印本、入选 ICML 2025 并在7月挂上官网的《Beyond Sensor Data》。苹果用 Mamba-2 架构训练了一个可穿戴行为模型(WBM),喂进了161,855名参与者(官网概数162,000人)超过25亿小时的数据、27项衍生行为与生理指标,一口气在57项健康相关任务上做评估。把 WBM 和 PPG 光学传感器组合起来后,模型在保留队列上的表现相当扎眼:妊娠检测 AUROC 达到 0.921,糖尿病状态 AUROC 0.828,感染检测 0.763,损伤检测 0.688,睡眠时长拟合优度 R² 为 0.601。到了2025年12月,苹果又发了一项涵盖超过4,000名参与者、长达12个月 iPhone 与 Apple Watch 数据的数字心理健康研究。
这些数字放在机器学习顶会里很漂亮,但放到医院诊室里完全是另一回事。95%是传感器之间的特征保留率,0.921是受试者工作特征曲线下面积(AUROC),衡量的是模型把阳性与阴性样本排开的能力,根本不是92.1%的临床诊断准确率。苹果自己在论文里把话留得很死,明确承认 WBM 模型仅用于检测当前状态,并非为预测未来健康状态而设计;12月那项心理健康研究也只验证了持续数字传感的可行性与高依从性,没有确立任何诊断准确性或治疗有效性。
传感器能算准手腕上的脉冲,不代表算法能治好病床上的患者。
医学界评判一个工具是否“有效(effective)”,金标准只有一个,就是患者用完之后发病率、住院率或死亡率有没有真正下降。苹果拿出的所有论文,目前都停留在“证明手表能从物理信号里筛出当前生理特征”的第一步。
两条路线与一场“数据囤积”危机
如果把视野拉宽,就能看清硅谷双雄在 AI 健康上截然不同的押注方向。Google(Fitbit)走的是自上而下的语言推理路线,其个人健康大语言模型(PH-LLM,2024年6月预印本、2025年发表于《Nature Medicine》)建立在 Gemini 衍生架构之上,主攻医学知识问答与包含857个案例研究的对话式睡眠、健身教练评估;它在睡眠医学问题上拿到 79%(抽样人类专家为76%),在健身问题上拿到 88%(抽样专家为71%)。苹果过去一直死磕底层的数值时间序列与生物标志物,试图绕开语言模型直接从25亿小时的物理传感里提炼健康状态,直到这次联手 OpenEvidence,才补上顶层临床文献问答这一课。
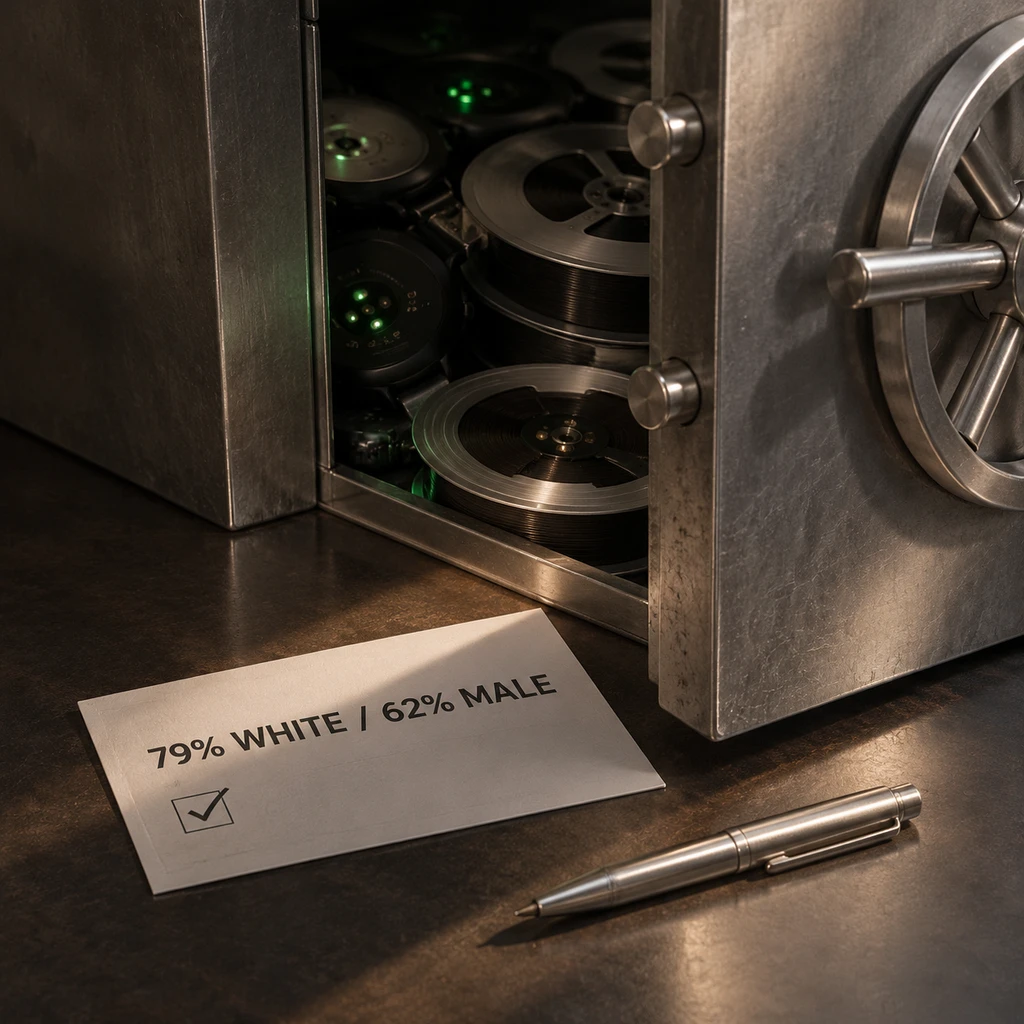
我不太买账的是,苹果一边用学术论文给自己贴满高精度的科学标签,另一边却把整套体系锁在既偏科又无法检验的黑盒里。翻开 WBM 预训练队列的人口统计学底牌,样本偏斜得让人捏一把汗:约 79%为白人、62%为男性,平均年龄40.7岁,而且许多健康结果标签直接来自受试者自我报告的问卷,本身就带着主观误差。加上数据全部采自 iPhone 和 Apple Watch,这套模型换到其他设备或外部人群身上还能不能灵,完全是未知数。
这种“只晒高分、不交数据”的做法,已经惹恼了独立学术界。2026年4月17日,杜克大学研究员 Anish Karpurapu、Zhicheng Guo、Cynthia Rudin 与埃默里大学研究员 Xiao Hu 在《npj Artificial Intelligence》联名发表论文,直接给苹果扣上了数据囤积(Data-hugging)的帽子。他们指出,苹果拒絕公开专有数据集和训练模型,导致外部科学界根本无法复现或证伪其宣称的异常强大的年龄估计结果;当这批学者用公共 PPG 数据集重做实验时,发现模型表现相比直接猜人群平均年龄几乎没有提升。公允地讲,杜克团队的反击也有局限,他们用的是英国生物银行(UK Biobank)简短的指尖脉搏记录,而苹果采的是长期的手腕记录,物理条件并不相同。但恰恰因为苹果把数据锁死,连“到底是手腕信号更准,还是苹果算法过拟合”这个基本科学问题,外人都没法验证。
十九世纪末美国的“专利药(Patent Medicine)”狂潮里,药商们最喜欢印制精美的化验单和用户证言,唯独拒绝公开配方表,直到1906年《纯净食品和药品法》强制要求亮出底牌,人们才看清里面大半是酒精和色素。今天的消费级医疗 AI 当然比当年的药水精密得多,但把商业护城河凌驾于科学可证伪性之上的利益逻辑,一百多年里并没有变过。
- 提醒.佩戴 Apple Watch 的普通用户(尤其是女性与非白人群体)不应将手表的健康提示或新研究里的问答打分当成临床诊断依据;接下来真正决定苹果健康 AI 成色的,是它敢不敢向独立学界开放部分脱敏基准数据集,以及何时交出第一份证明“改善患者真实健康结局”的前瞻性临床试验报告。