大模型降价不再靠在价目表上划斜线,而是逼模型学会自己少绕弯路。
Anthropic 在 2026 年 9 月 28 日正式推出了 Claude 5.5 系列的第二款模型 Claude Sonnet 5.5。最有意思的反常点在于它的计费方式:输入每百万 token 依然是 2 美元,输出依然是 10 美元,缓存写入与读取也维持在 2.50 美元和 0.20 美元,一分钱没降。但官方和早期测试给出的账单结果却截然相反——单个任务的综合交付成本最高降低了 30%,生成速度则提升了超 30%。更让人意外的是,在 Terminal-Bench 4.0 这类衡量自主编程的基准测试中,它从上一代 Sonnet 5 的 10.3% 暴涨至 70.6%,甚至越级反超了自家的顶级旗舰 Opus 5.5(66.4%)。
中端模型在跑分上背刺旗舰、名义价格纹丝不动而实际账单变便宜,这两件事同时发生,说明大模型的竞争维度彻底变了。
工具批处理与消失的调用轮次
过去我们算大模型账单,习惯把目光锁死在每百万 token 的字价上。但当模型真正进入生产环境接管终端、调用外部工具时,账单大头往往来自无节制的多轮确认与上下文重放。
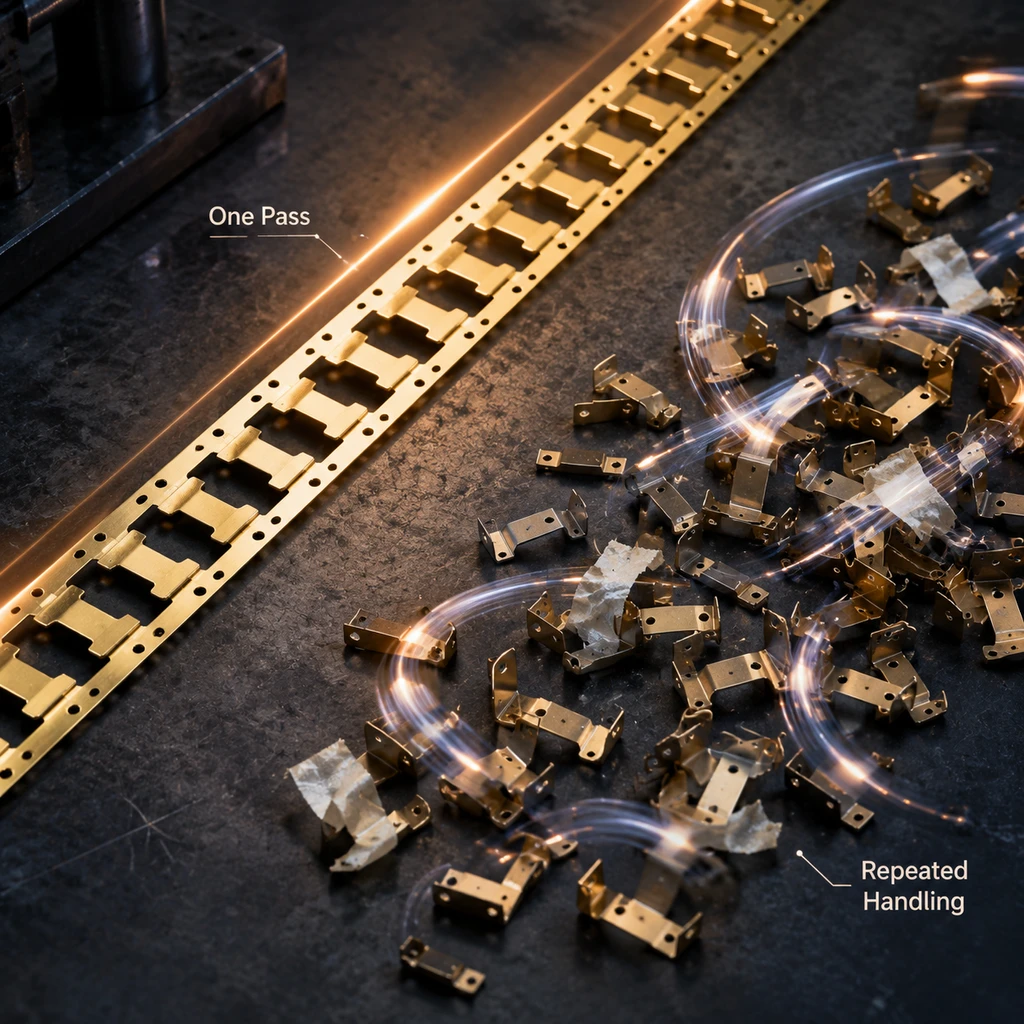
Sonnet 5.5 所谓的不降价而降本,核心全在工程层面的工具批处理。开发平台 Lovable 的测试记录显示,新模型在处理复杂代码修改时,工具调用总量减少了约三分之一,需要执行的 shell 交互命令近乎折半。原本需要模型试探运行、报错、再传回上下文重新推理的繁琐步骤,现在被合并为单次批量下发执行。
在实际代码上下文理解上,CursorBench 4.0 测出的得分从旧版的 34.1% 提到了 55.5%,仅落后 Opus 5.5 两个多百分点;在非工具辅助的图表理解基准 Chartography 上,成绩更是从 15.6% 跃升到了 61.6%。Epic 验证它已能支持数万行游戏引擎系统的架构审查与数小时连续长程任务。而在 OpenAI 主导的 GDPval-AA 综合知识工作基准测试中(涵盖 44 个职业、9 个产业),Sonnet 5.5 拿下了 1,844 分,几乎平视旗舰 Opus 5.5 的 1,846 分,同时把 GPT-6 Sol 的 1,487 分甩在身后。不过需要说明的是,Anthropic 官方公布的这组数据来自一个预发布测试版本,当时用于修复结构化输出的补丁尚未完全合入。
决定真实账单的早已不是单字字价,而是端到端完成一个需求所需的有效工时。
在名义单价上,竞对 OpenAI 的 GPT-6 Sol 基础价同样是 2 美元输入与 10 美元输出,但 OpenAI 暗含了一道门槛:当上下文输入超过 272K tokens 时,输入与缓存读取均加收 2 倍费用,输出更要加收 1.5 倍。相比之下,Anthropic 维持统一定价、纯粹通过压缩有效 token 消耗来降本的做法,对需要挂载完整代码仓库的企业更为实际。
| 评测维度与核心指标 | Claude Sonnet 5.5 | 上代 Sonnet 5 | 旗舰 Opus 5.5 | 竞品 GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 (编程) | 70.6% | 10.3% | 66.4% | 未测 |
| CursorBench 4.0 (IDE 场景) | 55.5% | 34.1% | 57.8% | 未测 |
| FrontierCode 1.1 (高推理) | 52.1% (Xhigh) | 42.4% | 54.4% | 49.3% |
| GDPval-AA (多专业知识) | 1,844 | 1,449 | 1,846 | 1,487 |
| 单测试综合估算成本 (Vals) | $20.80 | — | $32.77 | — |
算力过载的陷阱:Max 档位的推理倒挂
但跑分和宣传不会写在明面上的,是推理强度调节里的巨大暗礁。
当前新一代大模型普遍引入了推理算力档位调节,允许用户在响应速度和推理深度之间权衡。Anthropic 声称在 Low 或 Medium 档位下,Sonnet 5.5 就能以旧模型十分之一的综合成本打平以往的最佳表现。然而当档位拉满时,一件反常的事情发生了。
在衡量前沿编程能力的 FrontierCode 1.1 测试中,Sonnet 5.5 在次高档位 Xhigh 下拿到了 52.1% 的优异成绩;但一旦将推理强度拉到最高档 Max,得分反而下挫至 46.2%。
官方对这次倒挂给出的解释很直白:在 Max 强度下,模型会更频繁地自发触发代码审查逻辑,把任务切分派生给多个子代理并发执行。而在基准测试的严苛环境里,这种复杂的子任务审查不仅极易导致整体运行超时,还会诱使模型去修改原本不属于该任务范畴的代码,最终双重受罚。
这暴露出工程设计中极易踩中的陷阱。《淮南子》有言,事莫明于有效,论莫定于有证。过度推演在现实软件工程里从来不是美德,机器同样不例外。
这也解释了社区开发者在上线首日的体感分化。第三方评测机构 Vals 的数据显示,Sonnet 5.5 拿下了 69.22% 的得分,单次测试估算成本为 20.80 美元;旗舰 Opus 5.5 得分虽微升至 69.69%,但单次测试开销达到了 32.77 美元,成本整整高出约 58%。从纸面上看,Sonnet 5.5 的性价比无可匹敌。
但 Reddit 上的开发者很快反馈了另一面:一旦在复杂的长程任务里将推理档位拉到高位,由于子代理反复自我质询与多重嵌套,实际吞吐的 token 量呈指数级膨胀。到头来,跑完一个复杂需求的总体开销,反而可能超过一次成型的 Opus 5.5。不仅如此,在发布首日,部分使用 Claude Code 的开发者还遭遇了安全审查机制在 auto mode 模式下频繁超时的状况,导致工程命令直接中断。
- 风险.高推理档位不是万能药,无序派生的多子代理不仅会击穿 Token 预算,还会引入超时与代码越界的不可控风险。
生产落地的选型分界
Anthropic 现有的产品谱系正变得高度层级化:Fable、Opus、Sonnet 分别迎战 OpenAI 的 GPT-6 Astra、Sol、Luna,后续数周还将推出主打极致吞吐与微型成本的 Claude Haiku 5.5。与此同时,伴随模型能力向网络安全纵深切入,防护边界也在收紧。Sonnet 5.5 首次加入了针对高危网络安全任务的过滤重定向机制,遇到敏感请求会自动分流至上一代旧模型,同时布署了防蒸馏攻击分类器,以防止核心模型能力被非授权提取。
如何在生产环境中用好这个看似便宜但暗藏暗礁的工具,决定了技术投资是变成真正的利润还是失控的账单。
- 建议.普通业务逻辑编写、界面排版或测试生成,固定在 High 或 Medium 档位,利用其减少的工具调用吃满 30% 降本红利;只有在顶层系统架构设计与模糊推演时,才将任务直接交给全局把控力更强的 Opus 5.5,切忌在日常流水线中盲目拉满 Max 档位。
买模型不再是买每行字多少钱的原材料,而是在给数字雇工的工时买单。能一趟做对的平价模型是生产力,但自作聪明层层分包的子代理网络,只会让账单比代码更早崩溃。