大模型开发者社区最近几个星期普遍弥漫着一种挫败感:付费订阅的高级推理模型突然反应迟钝、频繁丢失指令甚至原地复读。2026年9月20日,开发者 Lon Lundgren 公布了历时六周的量化追踪数据,直接将矛头指向 Anthropic 旗下的核心模型 Fable 5。
这并不是一次单纯的感性吐槽。根据第三方对 Lundgren 数据集的二次统计,在2026年7月1日至9月7日跨多设备与版本的 43,261次 Claude Code 真实调用中,高达 39% 的请求得到的思考Token(thinking tokens)直接为零。这套严密的数据击穿了厂商与用户之间的信任防线:模型并没有在底层被暗中削弱,削弱的是用户每次按下回车时实际分流到的推理算力。
4.3万次调用里的算力退潮:当自适应思考变成零思考
问题的源头始于 Anthropic 机制设计的调整。Fable 5 于2026年6月9日发布,短暂下线后在7月1日重新部署上线。伴随这次重装亮相,Anthropic 引入了自适应思考机制,彻底取消了此前允许用户自行锁定的固定思考Token预算,转由系统依据提示词难度和设定的努力等级动态调配。
然而,这套原本旨在省流与弹性的机制,迅速沦为算力抽离的通道。统计显示,7月至9月上旬的整体调用中,思考Token的中位数仅有区区 123 个,8月份的实际交付量相对7月份缩水了 18%至50%。在8月22日前后,该中位数甚至一度跌落至零。
更令付费开发者沮丧的是,即便主动在客户端中把思考努力等级拉至最高档位,依然无法撬动应有的深度推演。数据显示,绝大部分调用几乎完全没有触发任何长程思考链,偶尔出现的长思考也从未触及基准测试所公布的上限水平。
真正发生变化的不是模型的认知天花板,而是每次交互实际分发到的算力制度。
榜首跑分与真实体验:被工程配置撕开的断层
这种体感滑坡最反常的地方在于它与权威基准测试的彻底割裂。就在开发者抱怨模型退化的整个8月,Fable 5 在评测榜单上几乎处于统治地位。
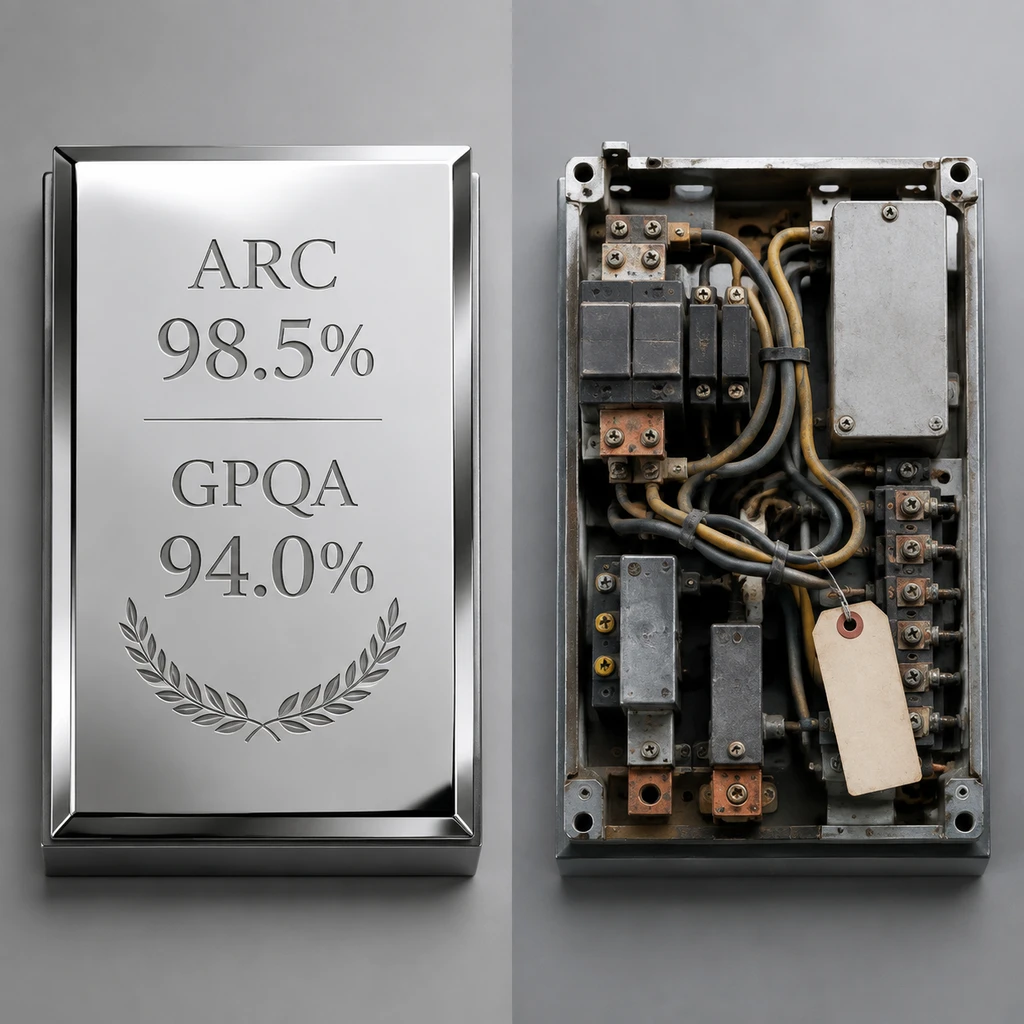
8月3日,该模型在 ARC-AGI-1 夺得 98.5% 的惊人高分;8月6日的 F5 Labs 能力榜上,Fable 5 以 59.9% 的平均得分和 98.01 的 CASI 安全分雄踞榜首,大幅拉开同期 GPT-5.6 Terra 的 45.6% 与 90.56;在 GPQA Diamond 评测中,它也拿下了 94.0%,与 Gemini 3.1 Pro 的 94.3% 并驾齐驱。
这份反差证明底层的神经网络权重并未被恶意损毁。造成能力断崖的元凶隐藏在工程配置层面。PolicyBench 的测试显示,仅仅是引入强制工具调用,就会让 Fable 5 的得分从 86.9 骤降到 79.9。同时,第三方逆向分析指出,在流量高峰和异常工况下,Fable 5 存在静默降级回退至旧版本 Opus 4.8 的痕迹。
系统的动荡在8月中旬集中爆发。8月7日 Anthropic 曾宣布改进生物安全防护规则,以减少约 85% 的生物类回退降级事件;然而到了8月18日,官方又立案调查了一起波及 Fable 5 和 Opus 5 等主力模型的严重性能降级事故。在安全审查收紧与基础设施抖动的双重夹击下,用户端拿到的交付规格被层层削蚀。
商业死结:固定月费装不下昂贵的深度推理
算力配给的根本动因最终仍要算商业账。大模型从直接输出时代跨入慢思考时代,推理计算的边际成本发生了质变。
Anthropic 现行的个人订阅体系依然沿用固定包月制:Pro 每月 $20,Max 5x 每月 $100,Max 20x 达到每月 $200。但根据官方说明,这些倍数仅代表相对于基础账号的容量上限,绝非保底的思考预算。在订阅初期,Pro、Max 与 Team 订阅者在7月7日前曾享有周使用限额 50% 的特别配额,随后迅速切换为常规消耗体系。
对比 API 定价就能看清其中的成本悬殊。Fable 5 的 API 标价为输入每百万Token $10、输出每百万Token $50。最关键的商业规则在于,所有的思考Token全部按输出费率全额计费。一个数十步的深度代码推演任务,若毫无节制地拉满思考链,单次交互的纯算力成本就可能消耗数美元。如果任由数十万月费20美元的用户无限释放思考计算,没有任何一家模型公司的算力集群可以承载。
虽然 Anthropic 已在2026年9月1日上线了 Claude Fable 5.1,维持 $10/$50 定价的同时降低了缓存读取成本,并向订阅用户开放,但这并未消除机制上的结构性矛盾。自适应思考的外衣掩盖了工程侧的削峰操作,厂商通过动态分配而非直接提价,把成本压力悄然置换成了交付体验的缩水。
- 建议.对于高度依赖推理确定性的工程团队,切勿将固定包月订阅视作可靠的生产力基石,改走支持明确Token预算管控的独立 API 接口才是规避算力抽离的唯一解法。
AI 行业的评测逻辑正因此迎来关键转折。当厂商卖出的不再是一个静态的模型权重,而是一套受到负载、事故和成本控制随时管制的推理配给体制,过往单纯基于公开榜单的静态跑分正在丧失指导意义。透明的推理服务等级协议(SLA)与真实的Token交付审计,才是接下来全行业不得不面对的真正考验。