海外科技社区最近流传着一个惊人的说法:阿里巴巴开源了一款高达 2.4 万亿(2.4T)参数的超级大模型。这个数字听起来骇人听闻,但只要稍微核对官方的技术报告,就会发现这不过是一场把训练语料数据量与模型体积张冠李戴的技术乌龙。
阿里从未推出过任何 2.4T 参数的模型。在开源大模型阵营里,真正接近两万亿参数门槛的庞然大物,是 Meta 在 2025 年 4 月 5 日随 Llama 4 系列公布、且首发并未开放权重下载的 Llama 4 Behemoth,其规格约为 2T 总参数搭配 288B 激活参数。把语料当参数,不仅制造了虚幻的算力神话,更遮蔽了通义千问这三年来最关键的技术蜕变。
语料级数与参数神话
Qwen 演进史里那些带“T”的数字,从来不是模型腰围,而是吞食的数据量。
2023 年 8 月,阿里开源 Qwen-7B 时,预训练语料规模刚超过 2.2万亿Tokens,并给出了月活跃用户 1 亿以下的免费商用授权。随后的一年多时间里,这个数字经历了一场指数级狂飙:Qwen1.5 语料扩充到约 3T,Qwen2 翻倍至约 7T,到了 Qwen2.5 更是直接冲上 18T。
2025 年 4 月 29 日正式发布的 Qwen3,其预训练数据量推进到了约 36万亿Tokens,语料覆盖 119 种语言与方言。从 2.2T 走到 36T,阿里堆叠的是清洗过的数据资产,而不是无休止膨胀的单一模型结构。所谓“2.4T 巨无霸”,只是外部在数字传导中的以讹传讹。
算力重构:235B 总量与 22B 激活
单纯增加密集模型(Dense)的参数量,在工业落地层面已经撞上了显存与推理成本的坚硬墙壁。
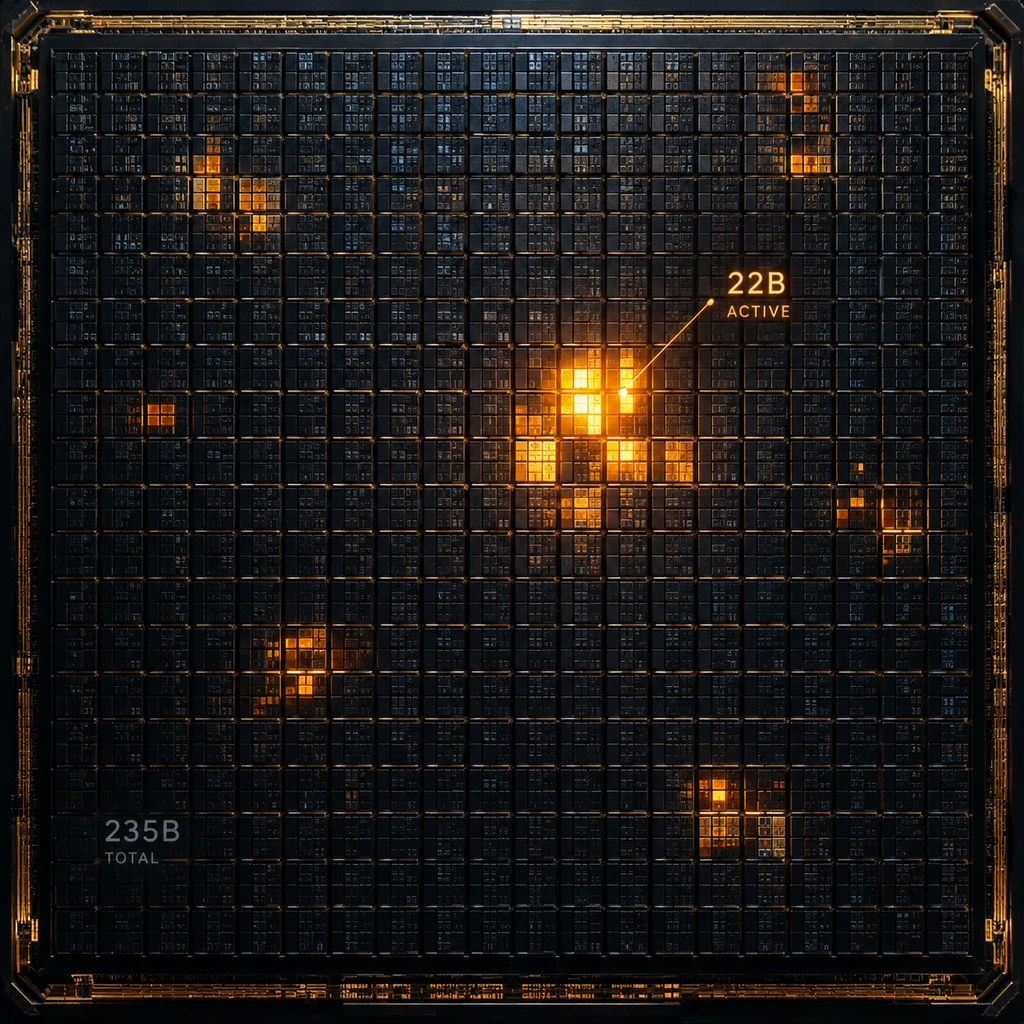
Qwen3 祭出的核心杀器并非单体庞然大物,而是混合专家(MoE)架构。其开源旗舰 Qwen3-235B-A22B 的总参数量定格在 2350亿(235B),但在实际推理时,每处理一个 Token 调动的激活参数量仅仅是 220亿(22B)。
这种架构设计的意图极具侵略性:用接近 20B 级别密集模型的实时计算能耗,去博弈两千亿级别大模型的知识广度与表达上限。面对 DeepSeek 的工程优化与 Meta 的全线围堵,阿里的解题思路不是跟风做无节制的体积膨胀,而是用极低激活比重重塑推理的能效曲线。
兵不在多而在御,大模型的胜负早已从体积竞赛转向能耗比的算度。
协议退让与工程落地阵痛
比起参数形态的转变,阿里在开源协议上的连续后撤更能说明生态战的残酷。
在 Qwen 系列的演进初期,开源带有鲜明的防御色彩。最早的 Qwen-7B 设置了严密的自定义商用许可,随后的 Qwen1.5 和 Qwen2 哪怕对小尺寸放开,也对 72B 与 110B 这类具有实际商用价值的顶配模型保留自定义条款;即便到了 Qwen2.5,阿里依然死守着 3B 与 72B 的协议栅栏。直到 Qwen3 首发全家桶 8 款模型面世,阿里才少见地彻底卸下防备,全量切换为宽松的 Apache 2.0 协议。
这种妥协并不是慈善,而是被竞品逼出来的生存动作。当 DeepSeek 撕开推理成本的口子、Meta 用巨量资金将 Llama 系列推向事实上的行业底座,带着繁琐商用限制的“半开源”很快会被开发者无情抛弃。
然而,全量拥抱 Apache 2.0 并不能自动抹平工程侧的断层。Qwen3 固然引入了思考模式与非思考模式的自由切换,但在社区开发者的实际生产落地中,一系列现实代价暴露无遗:
- 模型对特定的 Chat 模板与系统角色标记极度敏感,Prompt 格式微小的漂移就会导致指令遵循失效。
- 在本地量化部署场景中,其多步复杂推理能力呈现出明显的断崖式衰减。
- 所谓的思考模式在诸多日常任务中频繁诱发过度思考,导致吞吐延迟陡增并平白耗费大量计算 Token。
- 风险.MoE 架构虽压缩了计算激活量,但 235B 总权重对显存物理带宽的要求分毫未减,加上思考模式带来的 Token 膨胀,实际落地改造成本远超基准测试给出的预期。
古人讲“天下熙熙,皆为利来”。阿里从最初的小心试探到全面开放权重,背后是云厂商争抢生态标准的迫切欲望;但开源权重并不等同于开放了数据语料清洗清单与合规来源,开发者依然在黑盒边缘承受着未知的合规风险。
击碎 2.4T 的虚名之后,大模型战场的底牌变得愈发清晰:粗暴堆砌参数的时代已经终结,未来的分水岭,只属于那些能在显存墙、推理延迟与工程鲁棒性之间把账算明白的务实方案。
- 结论.放弃数字泡沫是务实的开始,当开源模型全面走向 Apache 2.0,工程中间件的调优成熟度将成为决定其实际存活率的真正考场。