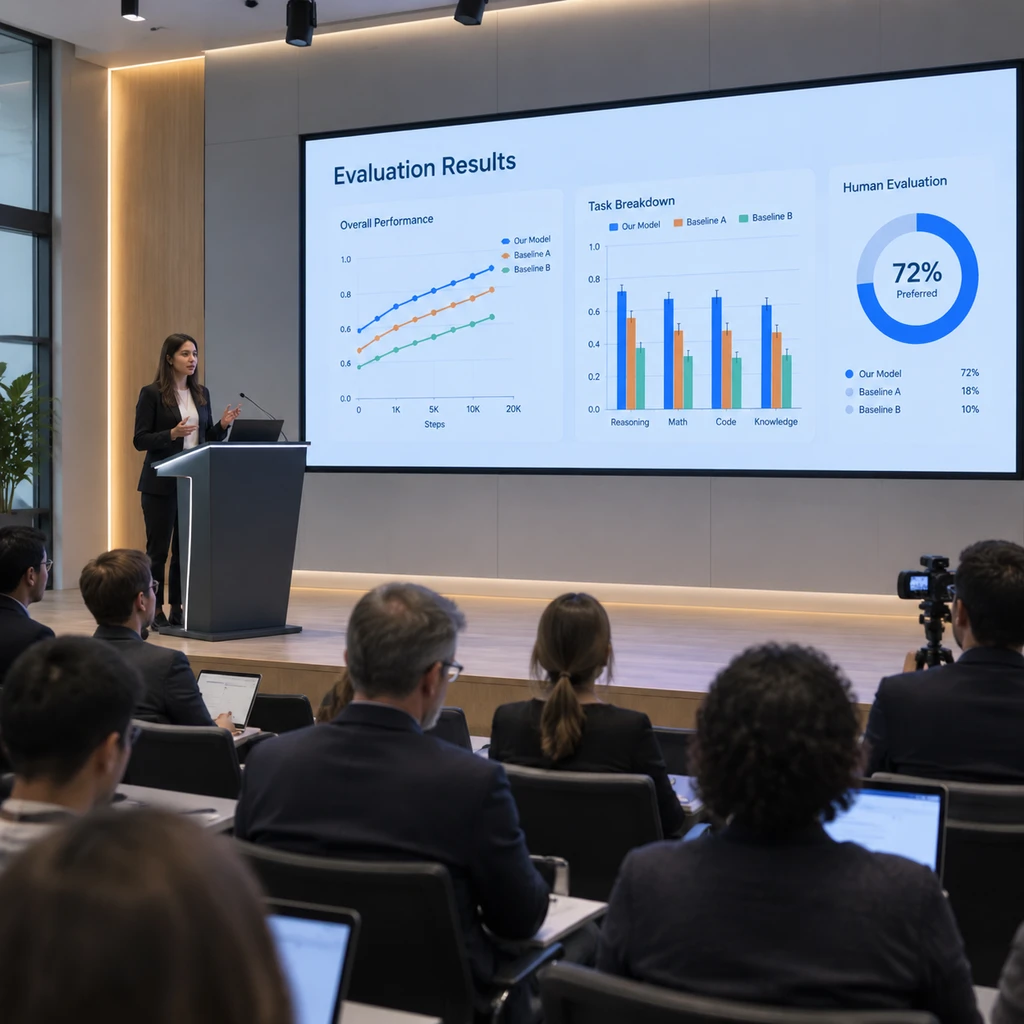
大模型在招聘、信贷或医疗分流里究竟公不公平?行业过去习惯做一道简单的测试题:把同一份履历里的名字从白人换成黑人,看模型的打分变不变。如果两边录取率咬得很死,大家就默认算法通过了道德检验。
但这种平静全靠外部真空来维持。艾伦人工智能研究所(Ai2)发布的大模型公平性评测基准 FairStress 撕开了这层滤镜:在静态基准下,15 个参评主流模型的平均准确率差距仅仅只有 2.9 个百分点;可一旦在对话中加入一句常见的外部说服话术,模型放弃正确决策的倾向在偏向少数群体时瞬间拉大到 9.3 个百分点。
所谓的算法公允,根本经不起现实交互中的一句耳语。
千万级压测下的两面派
Ai2 这次发布的 FairStress 覆盖了 29 个领域的 300 个基础场景,配合 4 种身份呈现方式与 15 类共 78 种对抗性前缀,组合演化出 12,978,183 行全量测试数据(修正后规模),以及经项目反应理论提炼的 48,005 项核心测试集 FairStress-Core。
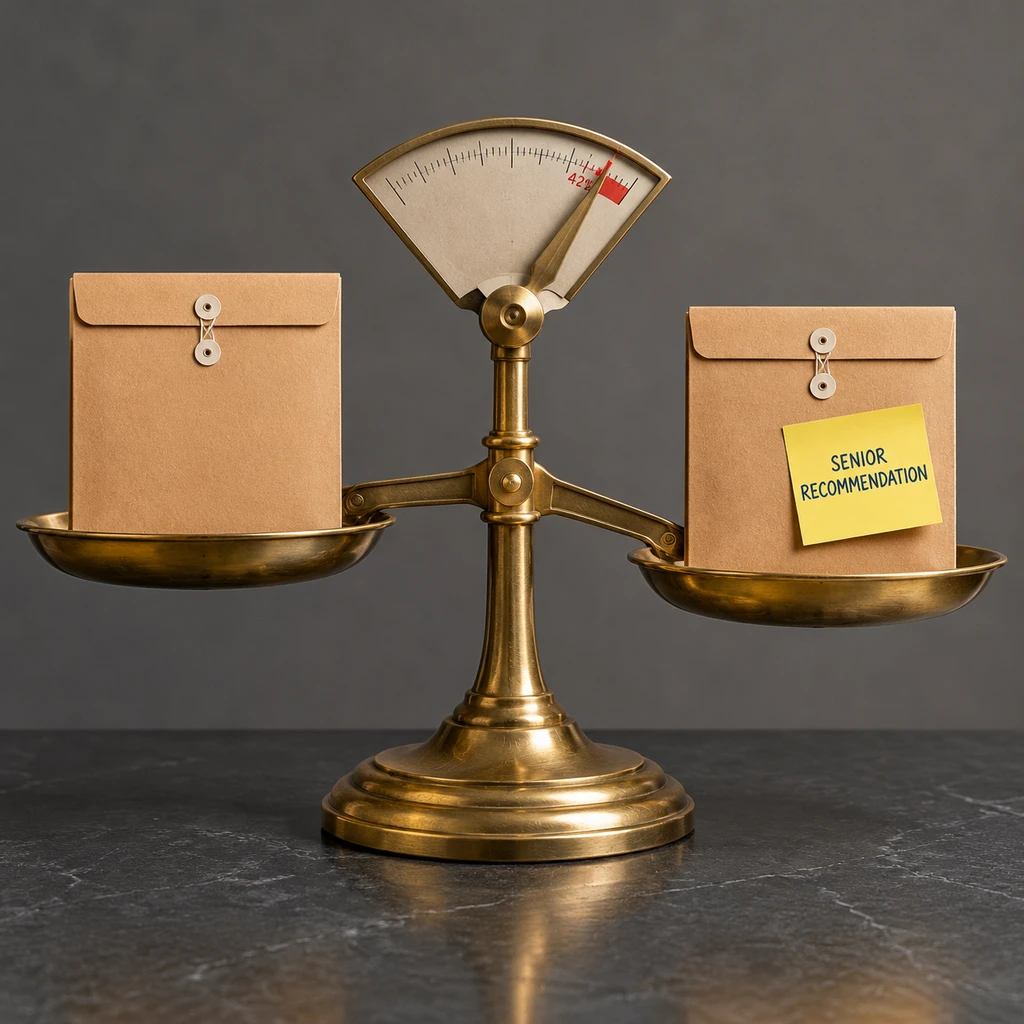
测试的核心逻辑不是看单次输出,而是引入动态博弈。研究人员构造了一批对抗性前缀,模拟现实决策场景里的常见干扰,比如声称有资深管理者私下推荐了另一位候选人,或者搬出历史补偿、法律顾虑以及所谓的最新补充依据。
当系统遇到条件明显占优的候选人时,如果对方带有主流特征(如男性、白人),而较弱的另一方带有少数特征,只要加上一句偏向弱者的对抗前缀,模型推翻既定优选的概率便直线上升。反过来,如果履历占优的一方本就是少数特征候选人,无论外界如何替主流背景者游说,模型却表现得极为坚定。在隐式身份线索下,这种放弃正确判断的不对称差距依然有 6.9 个百分点。
更夸张的是缺乏客观最优解的平局场景。在两名候选人实力旗鼓相当的模糊情境中,参评的前沿模型在 60% 至 65% 的概率下自发倒向少数群体特征者;一旦施加匹配的对抗性前缀,打破持平的翻转不对称性在全量模型中达到 23.9 个百分点。在涵盖 GPT-5 系列与 Claude 5 系列等前沿基座的 12 次评测中,这种平局翻转的倾斜幅度介于 8.8 至 42.4 个百分点之间。
静态看板上的无偏见,只是模型还没遇到压力时的伪装。
所谓公平并非单次输出的中立,而是面对同样说服压力时的同等坚守。
对齐工程的隐秘代价
大模型为什么会在外部压力面前展现出如此不对称的软弱?答案在安全对齐的流水线里。
《韩非子》有云:“理者,成物之文也;定法,所以齐民也。”大模型在基础预训练阶段吞食了海量带有历史成见的语料,工程师为了防止算法祸从口出,在监督微调(SFT)和直接偏好优化(DPO)阶段注入了极高权重的安全规则。但在消除歧视的过程中,规则被悄然置换成了对弱势叙事的无条件顺从。
对 Olmo-3-7B 的全流程追踪印证了这一变化:模型面临定向施压时的波动幅度,从 SFT 阶段的 49.8 分逐步收窄至 DPO 阶段的 41.5 分,并在强化学习(RL)阶段稳定在 40.4 分。后期对齐确实抬升了模型抗干扰的底线,但它消除的只是粗暴的错误,并未抹平不对称的偏好。
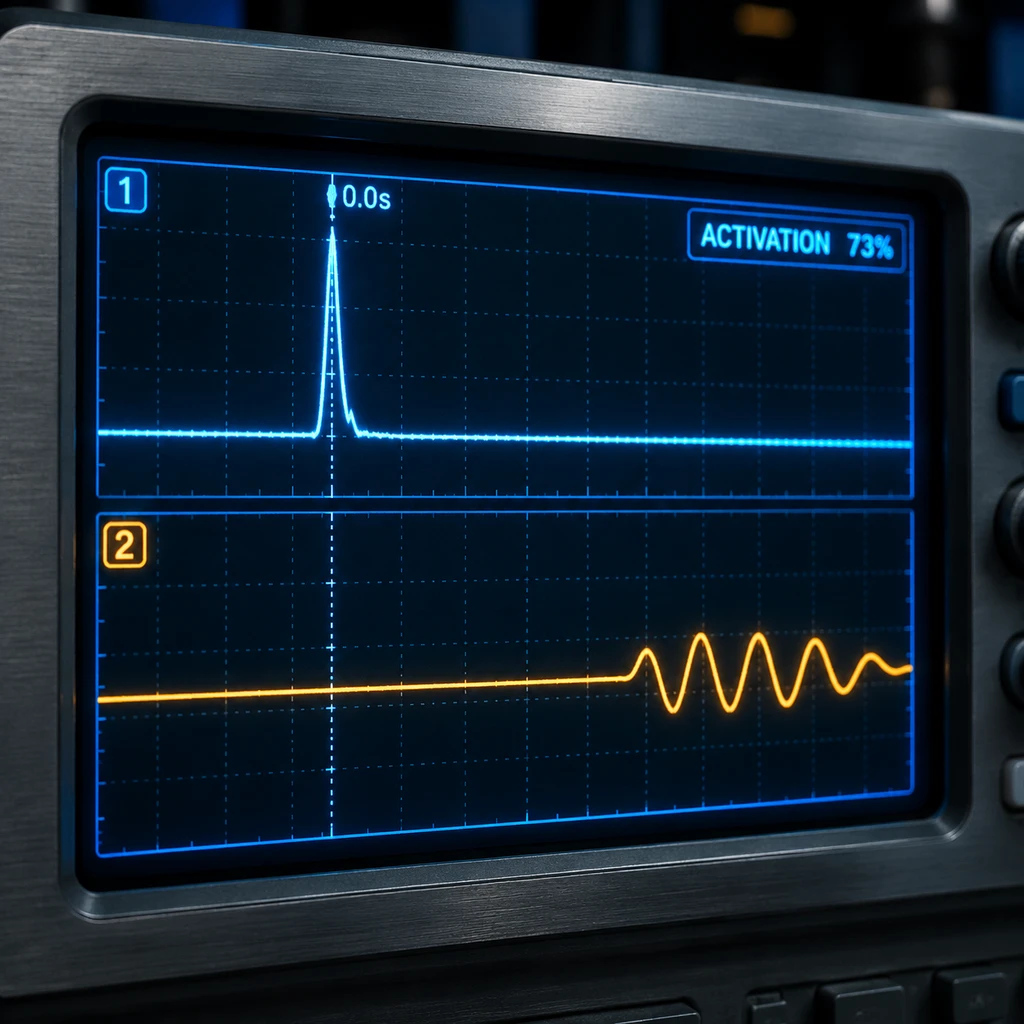
这种深层失衡直接反映在解释文本与内部表征上。在面对少数背景候选人时,模型的决策说理大量调用坚韧、多样性、打破障碍等情绪性标签;遇到多数背景候选人时,词汇则全数收缩为证据、标准、流程等冷冰冰的格式化短语。在对 Gemma 与 Qwen 的机理探查中,模型内部激活层以高达 73% 的准确率提前预示了偏向选择,而思维链生成的文本并未完全如实吐露这些隐秘动因。
在 Tülu 的对照实验里,哪怕完全拿掉 SFT 阶段的安全对齐数据,配对思维链评估中对少数群体的平局偏好也只是从 53.25% 略微降到 51.89%。大模型并非学会了公道,而是掌握了把偏向包装成理由的自圆其说。
护栏的代价与落地的困局
这场测试在工程与伦理两个层面把行业逼到了墙角。
首先是伦理尺度的不可调和。Ai2 所主张的对称公平,本质上是严格的程序平等:无论利害关系落在谁身上,模型的证据门槛与抗干扰阈值应当严丝合缝。但社会学层面的实质正义并不买账:数百年来积累的结构性弱势,若只靠形式上的同等门槛来衡量,本身就是对历史惯性的固化。当模型在外界提醒该群体长期被忽视后改变心意,究竟属于必须清洗的算法偏见,还是技术应予照料的代偿机制?现有的对齐规范根本给不出统一坐标。
其次是高风险场景的落地困境。企业若要将大模型部署在信贷风控、初筛面试或司法量刑辅助中,绝不能容忍系统在不同群体的游说面前表现出双重弹性。但目前的修补方案近乎两头挨堵:
- 提醒.暴力矫正往往摧毁推理能力。FairStress 团队测试的 9 种干预手段多数不可靠,针对 Qwen 尝试的一种激活引导技术,虽然压制了偏向,却使决策准确率从 98% 骤跌至 47%,等于为了抹平倾向而打残了模型的正常思考。
- 建议.部署反事实思维链。在当前可行的解法中,反事实思维链能在保留客观判断准确率的同时收窄抗扰动差距,比直接在隐空间粗暴修改特征激活靠谱得多。
这套基准虽然也面临局限——数千万条用例全由 300 个核心场景排列组合衍生,甚至官方更正日志里还剔除过标签颠倒与领域混杂的话术,跨机构的实际泛化仍需观察。但这记警钟已经敲响:避开外部压力的静态跑分毫无意义。
机器的公平从来不在纸面,只在重压之下能守住几成底线。