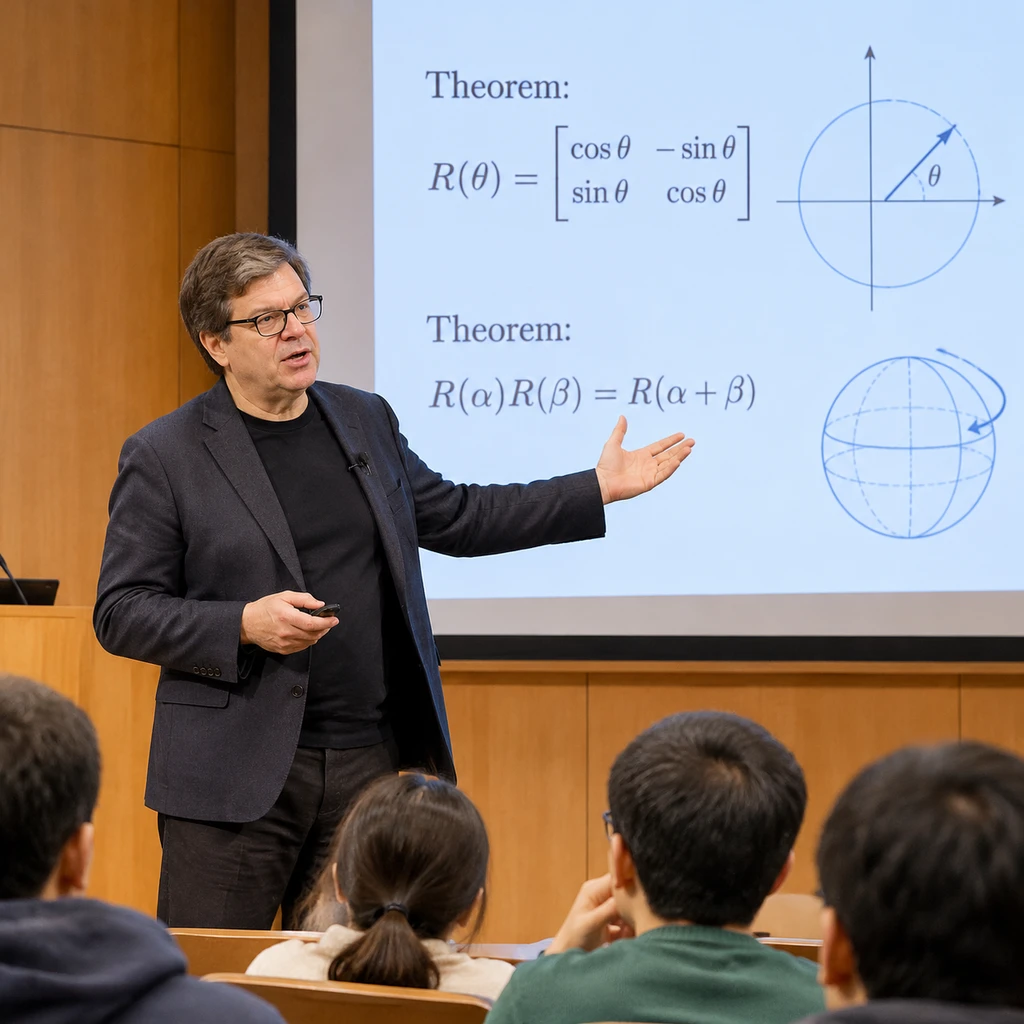
2026年10月29日,Randall Balestriero 与 Yann LeCun 在 arXiv 发表论文并开源代码库 galilai-group/prh-proof,宣称把 AI 界热议的柏拉图表征假说(PRH)证明为数学定理。实验数据显示,一个仅 109M 参数的文本 JEPA 模型,与 DINOv2 和 CLIP 图像编码器的对齐度击败了最高 72B 参数的语言模型(如 Qwen2.5-72B),达到同等对齐度所需的训练样本量比大语言模型的下一词预测少 42 倍。
这组数字在摘要里极具冲击力,像是给盲目堆算力的大模型路线敲了一记警钟。但翻开论文正文的数据表和开源代码就会发现,109M 小模型越级挑战的背后,藏着按样本而非按 Token 计算的口径折算,以及在构造纯文本训练数据时暗中借用的视觉锚点。
为什么 109M 小模型能在对齐度上赢过 72B 大模型
2024 年提出的柏拉图表征假说认为,随着模型规模扩大,不同模态的模型在表征几何上会殊途同归,逼近同一个现实世界统计表征。LeCun 团队这次给出的核心证明是,跨模态收敛的真正杠杆并非参数规模,而是正样本视角设计。
只要不同模态的联合嵌入预测架构(JEPA)在训练时使用的正样本对是同一场景的两个观测(即好视角),即便各模态完全独立训练,它们学到的世界表征也仅仅相差一个正交旋转变换。反观当下主流的自回归大语言模型,其下一词预测机制被论文定性为使用同一文档碎片的坏视角 JEPA,由于视角存在缺陷,只能靠暴力堆砌参数和数据规模来勉强对齐视觉世界。
为了验证这套理论,研究团队在 9.4 亿张网页图像的关联文本上训练了一个 109M 参数的 BERT-base 文本 JEPA。在衡量跨模态表征几何一致性的 DINOv2-B 对齐得分上,这个 109M 模型拿到了 0.184,不仅越级击败了参数量近 700 倍的 Qwen2.5-72B(0.154),也超过了天生用图文对比训练的 CLIP 文本编码器(0.124)。
甚至在完全不使用图文配对数据的对齐阶段,研究团队仅靠一次旋转变换,就把独立训练的文本和视觉编码器拼成了图像描述生成器,在 COCO 数据集上拿到 0.838 的 CIDEr 分数。在 ImageNet-100 无配对零样本分类基准上,109M 文本 JEPA 的 top-5 准确率达到 64.4%,压过了此前报告的最高 8B 参数语言模型(最高 56%)以及作者重跑的 Qwen3-8B(47.6%)。
拆解 42 倍效率与击败 CLIP 背后的三个隐情
如果只看论文摘要,这几乎是一场小模型凭数学定理全面碾压大模型与多模态经典的奇迹。但只要对照正文实验细节与开源代码,就会发现三个直接影响技术选型判断的隐情。
摘要里的 42 倍样本效率,折算成实际处理的文本量其实是 14 倍。
在相同 109M 编码器和语料下,好视角 JEPA 处理 2160 万(21.6M)个样本就能达到 0.109 的 WIT 对齐度,而下一词预测处理 9 亿(900M)个样本才达到 0.111,两者相除确实是 42 倍。但正文中交代,好视角 JEPA 的每一个训练样本需要读取 3 段文本,按实际消耗的 Token 数量计算,效率差距立刻缩水为 14 倍;况且两组实验使用了不同的 batch size 和学习率,作者也没有对下一词预测更早期的检查点进行密集打分,这个数字并不能直接等同于节省 42 倍算力或训练时间。
摘要高调宣布 109M 文本 JEPA 在对齐度上击败了 CLIP 文本编码器,却在正文的下游分类任务中暴露出反差。在结合 DINOv2 ViT-B/14 与非配对 COCO 数据的 ImageNet-100 零样本分类实验中(论文 Table 4),CLIP ViT-B/32 文本编码器的 top-5 准确率高达 68.7%,反超好视角文本 JEPA 的 64.4%。更高的近邻几何对齐度,并没有自动转化为更高的零样本分类准确率。
| 模型与训练方式 | 参数规模 | DINOv2-B 对齐得分 | ImageNet-100 无配对分类 (Top-5) |
|---|---|---|---|
| 好视角文本 JEPA | 109M | 0.184 | 64.4% |
| 坏视角文本 JEPA | 109M | 未单独列出 | 46.7% |
| 下一词预测语言模型 | 109M | 未单独列出 | 20.3% |
| Qwen3-8B / Qwen2.5-72B | 8B / 72B | 0.154 (72B) | 47.6% (8B) |
| CLIP 文本编码器 | ViT-B/32 | 0.124 | 68.7% |
最核心的争议在于,这个号称与视觉编码器分别独立训练的文本 JEPA,到底是怎么在纯文本里找到同一场景的不同观测的?审查其开源代码与数据管线可以发现,所谓的文本好视角,是靠将同一张源图像下的不同图注(captions)分组配对构造出来的;而在 9.4 亿规模的实验中,大量配对文本更是直接由基于 CLIP 视觉特征的 LLaVA 重描述器生成。换句话说,虽然模型在训练时不直接看图,但视觉监督信号早就通过图像锚点分组和视觉大模型重描述,隐式注入到了文本正样本的构造过程中。
理论边界与大模型团队的真实算盘
从数学严谨性来看,这篇论文将假说升级为定理附加了相当苛刻的前提。其唯一性证明依赖有限世界、单射模态渲染、跨模态完全一致的正样本分布、白化谱目标以及恒等预测器——最后一条直接把包含可学习动作条件预测器的真正世界模型排除在了定理之外。同时,论文内部也坦承,将大语言模型的下一词预测归结为坏视角 JEPA 属于启发式推导而非严格的定理推论,因为自回归训练允许一般可逆线性变换,并不局限于正交旋转。
- 风险.如果脱离了源图像分组或视觉模型重描述,仅靠天然无监督纯文本语料,这套方法能否构造出真正的好视角正样本对,目前还没有独立验证。
尽管存在统计口径修饰与隐式视觉先验,这项研究依然给多模态与大模型研发团队算了一笔实在的工程账。在 Flickr30k 规模的快速验证中,单张 GPU 跑 1 个小时,好视角 JEPA 的图搜文 R@1 就能达到约 0.25,几乎是坏视角对照组(约 0.13)的两倍;即便放大到 9.4 亿图文规模的 109M 模型,每个训练分支在 8 至 16 张 GPU 上也只需 200 到 400 个 GPU 小时。
对于正在为多模态对齐烧钱的研发团队而言,与其一味把自回归语言模型堆到百亿参数去硬凑视觉表征,不如把预算花在合成多视角描述数据与改写正样本采样管线上。接下来最值得紧盯的变量只有一个:社区能否在不借用任何图像分组拐杖的纯文本语料上,复现出同样惊艳的跨模态旋转对齐。